先说结论
Agent 不应该默认让所有任务都使用 Sonnet 或 Opus,也不应该为了省钱把所有请求都交给 Haiku。更合理的做法是:根据当前任务和执行步骤,选择能够达到质量要求的最低成本模型;当执行结果不满足要求时,再有边界地升级。
这里有两个经常被混淆的问题:
- Router 用什么模型做判断? 这是分类器本身的成本、速度和判断准确率问题。
- Router 应该把任务交给什么模型? 这是执行模型与任务之间的能力匹配问题。
它们不必使用同一个模型。Haiku 可以负责大部分简单的路由判断,Sonnet 负责少量复杂、模糊的决策,真正的执行任务则可能由 Haiku、Sonnet、Opus 或其他模型完成。对于可以明确判断的任务,规则引擎甚至不需要调用 LLM。
2026 年的研究和工程实践已经说明,Model Routing 正从 API Gateway 的模型转发功能,向 Agent Harness 内部的任务级、步骤级决策发展。本文重点讨论后者。
一、先区分几种 Router
日常讨论中,Model Router、Load Balancer、Fallback 经常被混为一谈,但它们解决的不是同一个问题。
| 类型 | 决策对象 | 解决的问题 |
|---|---|---|
| Load Balancing | 同一模型的服务实例 | 吞吐、排队和可用性 |
| Provider Fallback | 同能力等级的服务提供方 | 限流、超时和服务故障 |
| Semantic Routing | 不同模型或模型组 | 根据请求主题选择专长模型 |
| Capability Routing | 不同能力等级的模型 | 根据任务要求分配推理能力 |
| Agent Step Routing | Agent 的每个执行步骤 | 同一任务内动态分配模型 |
| Adaptive Cascading | 模型及后续执行策略 | 先低成本尝试,必要时升级 |
我们此前讨论过的 Thompson Sampling 如何优化 LLM 路由 主要研究供应商延迟、失败率、服务等级和在线成本优化。本文讨论的是另一层:当前这项工作究竟需要多强的模型?
两者可以组合,但不应该共用一个未经区分的评分函数。前者决定请求发给哪个可用服务,后者决定 Agent 应该调用哪一级能力。
二、理论基础:不是判断问题难不难,而是判断强模型能带来多少收益
2.1 RouteLLM:预测强模型是否值得使用
RouteLLM: Learning to Route LLMs with Preference Data 是这一方向的代表性研究。
它没有简单地把问题分成简单和困难两类,而是利用强模型与弱模型对同一问题的回答偏好,训练一个 Win Prediction Model,预测强模型在当前问题上胜过弱模型的概率。
设:
- (P_s(q)):强模型在问题 (q) 上胜过弱模型的概率。
- α:路由阈值。
- (C_s)、(C_w):强模型与弱模型的调用成本。
当预测的强模型收益超过阈值时,才选择强模型。提高阈值会让系统更偏向便宜模型,降低阈值则会增加强模型调用比例。
这个思路有一个重要含义:任务复杂度不等于模型收益。
一个复杂的 SQL 查询,如果小模型已经能稳定生成正确结果,就不一定需要 Sonnet。一个看起来很短的架构决策问题,如果包含多个隐含约束,反而可能需要强模型。
Router 应该估计的是模型之间的相对能力差异,而不是只给输入打一个难度分数。
2.2 FrugalGPT:先尝试便宜模型,再判断是否升级
FrugalGPT 提出了模型级联(Cascade)的思路。
先使用成本较低的模型生成结果,再由质量判断机制决定是否继续调用更强的模型。它与 RouteLLM 的主要区别是:
- RouteLLM 可以在生成前直接选择模型,通常只调用一个执行模型。
- Cascade 先生成一个答案,再根据结果决定是否调用下一个模型。
Cascade 有机会进一步节省成本,但需要额外的质量评估,也会增加串行延迟。
假设:
- 便宜模型调用成本为 (C_w);
- 强模型调用成本为 (C_s);
- 便宜模型失败概率为 (p);
- 暂不考虑验证器和上下文重建成本。
那么先用便宜模型的期望成本为:
[ E(C_{ ext{cascade}})=C_w+pC_s ]
当:
[ C_w+pC_s<C_s ]
即:
[ p<1- rac{C_w}{C_s} ]
Cascade 才比直接调用强模型便宜。实际系统还要把验证成本、重试成本和上下文重新填充成本计算进去。
这也解释了为什么不能只看单次 Token 价格。一个便宜模型如果需要反复重试,最终可能比 Sonnet 更贵。
2.3 LLMRouterBench:复杂 Router 不一定优于简单基线
LLMRouterBench 提供了超过 40 万条样本、21 个数据集和 33 个模型的统一评估框架。
研究发现模型之间确实存在互补性,但不少路由方法在统一评估中表现相近,部分复杂方法不能稳定超过简单基线。模型池的合理选择、训练数据和实际工作负载,可能比路由算法本身更重要。
这对工程实现有直接影响:第一版不需要训练一个复杂的 Router。先建立任务分类、模型能力档案和真实执行结果,通常更容易验证价值。
2.4 从 Query Routing 到 Agent Routing
近一年的研究开始把路由对象从单次 Query 扩展到 Agent 的执行过程。
Planner-as-Router(2026) 将模型选择放入规划阶段。Planner 分解任务时,同时为每个子任务指定 small、mid 或 frontier 模型,并考虑子任务之间的依赖关系。论文在 54 个企业任务上报告,相比全部使用 frontier 模型,成本下降 44%,准确率下降 2.9 个百分点。样本规模有限,结果应视为研究证据,而不是生产收益承诺。
AgentRouter(2026) 研究一个 Agent 轨迹中不同步骤的模型分配。Planning、Coding、Research 和 Data Analysis 的能力要求并不相同,因此不应该把一个 Thread 的所有调用绑定到同一个模型等级。论文报告了相对 frontier-only 基线的成本和质量改进,但仍属于研究阶段。
论文:AgentRouter
Agent-as-a-Router(2026) 引入 Context → Action → Feedback → Context 的闭环。Router 从真实执行结果中积累经验,逐步学习不同任务类型与模型能力之间的关系。
HM-Router(2026) 进一步联合选择 Model 和 Harness。Agent 的能力不仅取决于模型,也取决于工具、上下文管理和执行框架。
论文:HM-Router
这些研究共同指向一个方向:Auto Router 不应该只是一个输入分类器,而应该逐渐成为 Agent Runtime 的一项决策能力。
三、工程实践:LangChain 已经把 Router 放进 Agent Harness
How to Build a Model Router in the Harness 是 2026 年很有参考价值的工程实践。
LangChain 在 Open SWE Coding Agent 中分析了一周的真实 Agent Trace,先识别任务类型,再比较各类型任务的调用次数、成本和复杂度,最后选择 Fast、Balanced、Performance 三档模型。
它的 Router 包含三个部分:
- Base Prompt:要求分类器选择最便宜且能够完成任务的模型。
- Tier Criteria:为每个模型等级定义适合承担的工作。
- Classifier Model:读取用户任务并返回结构化的模型等级。
第一版使用普通 LLM 和 Structured Output,后来改用 Jev 决策模型。LangChain 报告分类速度提高约 50 倍。
它进行了两组对照实验中的第一组正式 A/B 测试:973 个线程,Router 组与始终使用 GPT-6 Astra 的对照组比较。Router 组的 Median Cost 从 $2.61 降至 $0.94,降低 64%;PR Merge Rate 为 29.2% 对比 27.3%,没有观察到统计显著差异(p=0.49)。
路由结果中,34% 进入 Fast,56% 进入 Balanced,只有 10% 进入 Performance。
这组数据不能直接外推到其他 Agent,但它证明了一件事:先分析真实任务,再设计路由策略,通常比先写一个通用的复杂分类器更有效。
LangChain 还明确指出了当前实现的边界:它在 Thread 开始时选择模型,整个 Thread 使用同一个模型;Subagent Routing 和 Mid-thread Re-routing 仍是后续改进方向。模型切换也可能影响 Prompt Cache,增加上下文重新填充成本。
Router 应该放在 Gateway 还是 Harness?
Gateway 能看到模型请求、Token 数量、Provider、延迟和错误信息,但未必知道 Agent 正在执行什么任务。
Harness 则能看到:
- 当前任务目标和任务类型;
- 当前是 Planning、Coding、Research 还是 Formatting;
- Agent 已经调用了哪些工具;
- 当前计划和上游子任务的结果;
- 已经发生过几次失败或重试;
- 当前任务的预算、截止时间和质量要求。
因此,任务能力路由应该主要放在 Harness;Provider 负载均衡、限流和故障回退仍然放在 Gateway。
两层可以组合:
- Harness 选择模型等级和执行策略。
- Gateway 选择具体 Provider、部署实例和服务等级。
- Runtime 负责执行、重试、验证、记录和状态恢复。
不要让一个 Router 同时承担任务分类、模型能力匹配、供应商故障恢复和在线负载均衡。它们需要不同的输入、评价指标和故障策略。
四、Router 本身应该使用什么模型?
这是本文最核心的问题。
先区分 Router 的两种工作负载。
第一种:分类。
输入一段任务描述,返回 fast、balanced 或 performance。输出是有限的结构化标签,不需要生成完整计划。
这种工作负载优先考虑:
- 规则引擎;
- 小型分类模型;
- Haiku 级别模型;
- 专门的 Decision Model。
如果任务类型清晰、分类边界明确,Haiku 通常是合理的起点。它速度快,成本低,而且可以通过 Structured Output 限制输出范围。
第二种:规划和判断。
Router 需要阅读较长的上下文、理解依赖关系、分析风险、判断模型能力差异,甚至决定是否拆分任务。
这时它已经不只是分类器,而是 Planner 或 Orchestrator 的一部分。对于高不确定性、高影响任务,Sonnet 可能更合适;极少数复杂架构决策或长周期规划才需要更强模型。
Haiku、Sonnet 和 Opus 的职责划分
| 工作内容 | 建议的决策模型 | 执行模型可能的选择 |
|---|---|---|
| 任务类型识别 | 规则 / Haiku | 不涉及 |
| 简单子任务分配 | Haiku | Haiku |
| 常规 Coding / Research 路由 | Haiku / Decision Model | Haiku / Sonnet |
| 复杂需求、歧义和依赖分析 | Sonnet | Sonnet / Opus |
| 高风险架构决策 | Sonnet 或强模型 | Opus / 强模型 |
| 执行结果质量判断 | Haiku / 专用 Verifier | 根据结果升级 |
这里的 Haiku、Sonnet、Opus 代表能力等级,而不是固定的模型名称。实际选择还要考虑具体版本、Reasoning Effort、工具调用能力、上下文窗口、结构化输出支持和任务成本。
Anthropic 的 Choosing a model 也建议根据能力、速度、成本和具体评测选择模型。它同时强调,模型的 Effort Level 也是重要的成本与能力调节手段。
一个容易忽略的问题:Router 自己也会产生成本
假设每个请求都先调用 Sonnet 判断应该使用 Haiku 还是 Sonnet,那么简单任务也要额外付出一次 Sonnet 调用成本。
Router 的目标不应该是追求最高分类准确率,而应该是:
[ min E(C_{ ext{router}}+C_{ ext{execution}}+C_{ ext{retry}}+C_{ ext{verification}}) ]
同时满足:
[ Quality geq Q_{min} ]
[ Latency_{p95} leq L_{max} ]
这比单纯最小化每百万 Token 的价格更接近真实业务目标。
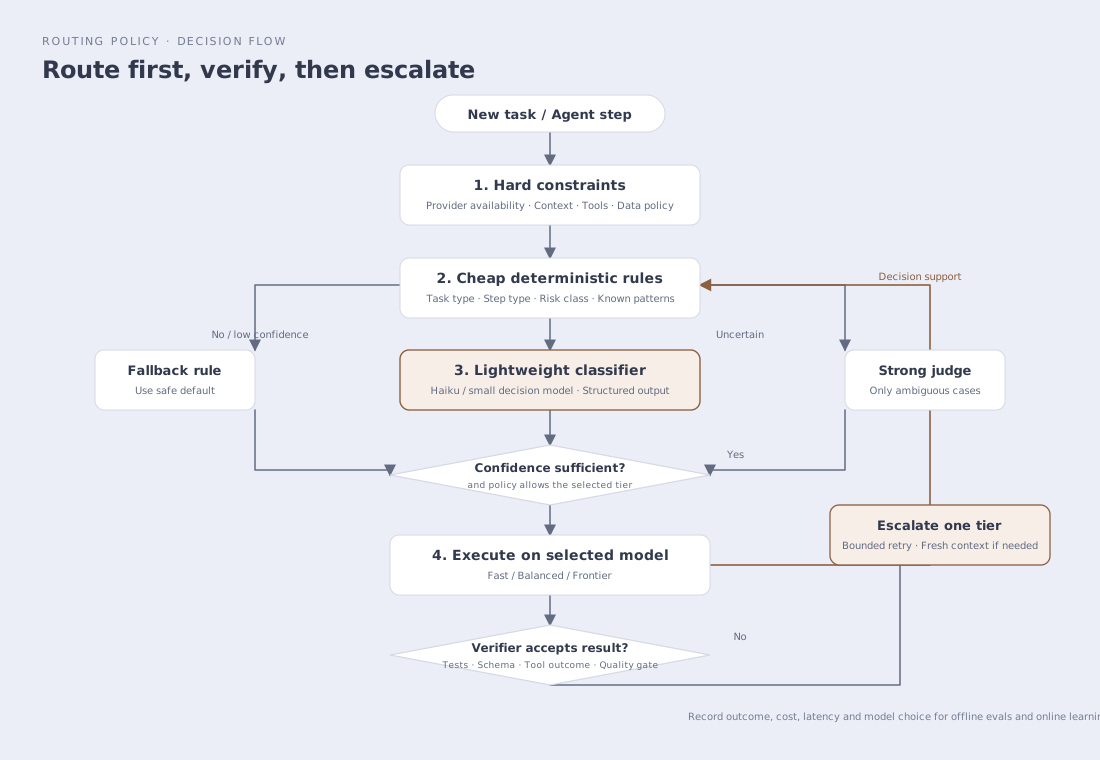
因此,我建议采用三层决策:
- Rule-based Router:处理明确的任务类型、硬约束和已知模式。
- Cheap Classifier:处理大部分需要语义理解的任务,默认 Haiku 或轻量 Decision Model。
- Strong Decision Model:只处理分类置信度低、任务风险高或依赖关系复杂的情况。
强模型应该是路由判断的升级选项,而不是默认入口。
五、推荐架构:从静态选择发展到动态升级
建议把 Auto Router 拆成四个独立职责。
5.1 Model Registry:记录模型真实能力
不能简单地把模型分成 Small、Medium、Large 三档,然后认为同一档中的模型可以互换。
Model Registry 应该记录:
- Provider 和 Model ID;
- 模型等级及能力标签;
- 输入、输出价格;
- 上下文窗口和输出限制;
- Tool Calling、Structured Output、Vision 等能力;
- Reasoning Effort 支持情况;
- 不同任务类型下的历史成功率;
- 实际成本和延迟分布。
模型能力应来自官方规格、公开评测和本地任务 Evals,而不是模型名称或参数量。
5.2 Task Profile:描述当前执行步骤
Router 不应该只读取用户最初的 Prompt。
对于 Agent Runtime,建议至少识别以下任务类型:
| Task Type | 典型工作 |
|---|---|
| Retrieval | 文件搜索、文档查找、读取日志 |
| Transformation | 格式转换、简单代码生成、数据清洗 |
| Implementation | 功能开发、Bug 修复 |
| Analysis | Root Cause、复杂 SQL、数据分析 |
| Planning | 任务分解、依赖分析、执行计划 |
| Architecture | 架构设计、技术选型、Trade-off |
| Verification | 测试、结果校验、代码审查 |
同时记录任务的模糊程度、推理深度、上下文依赖、失败代价、是否涉及外部副作用,以及剩余预算。
不要把这些维度机械地加权成一个总分。它们的作用是描述任务,让 Router 结合模型能力和真实评测结果进行判断。
5.3 Model Decision:选择模型和执行预算
建议 Router 输出结构化决策,而不是返回一段自然语言建议。
例如:
type ModelTier = "fast" | "balanced" | "frontier";

interface RoutingDecision {
  modelTier: ModelTier;
  reasoningEffort: "low" | "medium" | "high";
  confidence: number;
  maxAttempts: number;
  reasonCode: string;
}
这里的 confidence 是分类器对自己决策的估计,不应该直接当作任务成功概率。两者需要通过实际数据校准。
同时,Router 不应该直接接受任意模型 ID。模型必须从 Model Registry 的允许列表中选择,避免用户输入或 Prompt Injection 将请求引导到未授权 Provider。
5.4 Verifier 与 Escalation:让执行结果参与下一次决策
预路由只能估计任务难度,不能保证执行成功。
执行完成后,应该使用与任务类型对应的验证方式:
- Coding:测试结果、Lint、构建和代码变更范围;
- SQL:执行结果、Schema 和业务约束;
- Data Extraction:Schema、必填字段和抽取准确率;
- Research:证据覆盖、来源质量和结论一致性;
- Architecture:约束覆盖、依赖完整性和 Trade-off。
如果结果不满足质量要求,再升级到更强模型。
但升级不是无限重试。需要限制升级次数、预算和截止时间。对代码修改等任务,升级时还要考虑是否应重新生成,还是让强模型检查已有结果。
六、在 Copilot SDK、LangChain 和 Pi 中怎么实现
6.1 Copilot SDK:Session Model + Custom Agent Model
Copilot SDK 已经提供了两类可以直接利用的能力。
第一,Session 创建时可以指定 model,运行过程中也可以通过 session.setModel() 切换模型。模型切换在下一条消息生效,并保留会话历史。
第二,Custom Agent 可以通过 model 和 reasoningEffort 设置自己的模型覆盖值。这样,父 Agent 可以使用 Sonnet 进行复杂规划,而特定子 Agent 使用 Haiku 执行简单任务。
官方文档:
- Copilot SDK Node.js
- Custom Agents and Sub-agent Orchestration
- Session Persistence and Model Switching
推荐设计:
const HAIKU_MODEL_ID = process.env.ROUTER_HAIKU_MODEL!;
const SONNET_MODEL_ID = process.env.ROUTER_SONNET_MODEL!;

const session = await client.createSession({
  model: SONNET_MODEL_ID,
  customAgents: [
    {
      name: "research",
      description: "Document lookup and factual retrieval",
      model: HAIKU_MODEL_ID,
      prompt: "Research using available tools and return sourced findings."
    },
    {
      name: "architect",
      description: "Complex architecture and design decisions",
      model: SONNET_MODEL_ID,
      prompt: "Analyze constraints, alternatives and trade-offs."
    }
  ]
});
这里的关键不是让 SDK 自己猜测模型,而是让 Runtime 的任务分配策略与 Custom Agent 的模型配置协同工作。
Copilot SDK 还支持 model: "auto",以及 efficiency、balance、intelligence 等 Auto Tier。这是 Copilot Runtime / Provider 管理的自动路由偏好,与应用自己实现的 Semantic Router 不同。不能假设它会按照应用内部的任务分类、预算和验证规则做决策。
另一个限制是,session.setModel() 是针对后续消息的 Session 级切换,不等于可以拦截 Agent 内部每一次模型调用。对于需要精确控制每个执行步骤的场景,应使用独立的子 Agent、任务边界或自有 Orchestration Runtime,而不是试图把 Session Model Switch 当成完整的 Step Router。
6.2 LangChain / DeepAgents:Middleware 是最自然的接入点
LangChain 已经提供 Dynamic Model Selection Middleware,可以在模型调用前根据 State 和 Runtime Context 替换模型。
参考:
这种方式的优点是 Router 不需要侵入 Agent 的业务逻辑,可以作为 Middleware 插入执行链。
DeepAgents 建立在 LangChain / LangGraph 的 Agent 体系之上,因此也可以采用同样的思路:由 Middleware 或任务分发层选择模型,子 Agent 根据任务类型配置不同模型。
但不要只在每个 Agent 的创建配置里写死一个模型。那只是静态分配,不是 Auto Router。真正的动态路由需要结合当前任务状态、执行步骤和历史反馈。
6.3 Pi:通过 Agent Session 的模型切换实现
Pi Coding Agent 的 AgentSession 提供 setModel(),能够在运行期间改变当前 Agent 使用的模型,并记录模型切换事件。
它提供了动态切换的基础,但不等于已经具备完整的任务级 Router。需要在 Extension 或外部 Harness 中实现任务分类、模型能力档案、路由策略和执行反馈。
如果需要控制每个 Subagent 的模型,应将任务分配与各自的 Agent Session 绑定,避免多个并发任务共享一个可变的模型选择状态。
七、如何评估 Router 是否真的有效
不能只统计有多少请求进入 Haiku。一个 Router 即使 90% 请求都使用 Haiku,如果任务失败率明显提高,也不能称为成功。
建议至少建立以下对照组:
| 实验组 | 路由策略 | 用途 |
|---|---|---|
| A | Always Frontier | 质量基准 |
| B | Always Fast | 成本基准 |
| C | Static Rules | 简单规则基准 |
| D | Haiku Classifier | 低成本分类 |
| E | Sonnet Classifier | 强模型分类 |
| F | Adaptive Cascade | 执行后验证与升级 |
核心指标:
- Task Success Rate:任务是否真正完成,而不是模型是否返回了答案。
- Quality Regression:与 Frontier 基线相比,质量下降多少。
- Cost per Successful Task:完成一个成功任务的实际成本。
- Latency p50 / p95:特别注意 Cascade 带来的串行延迟。
- Escalation Rate:便宜模型执行后升级的比例。
- Classifier Overhead:Router 本身的调用成本和延迟。
- Segment-level Quality:不同任务类型、风险等级和用户群体的质量表现。
离线评测应同时测试所有候选模型,形成同一任务上的配对结果。这样才能判断某个 Router 是否选到了真正适合该任务的模型。
还应保留 Oracle Routing 作为理论上限:假设事先知道每个任务哪个模型最便宜且能够成功,最多能节省多少成本?实际 Router 与 Oracle 之间的差距,反映了路由策略还有多少改进空间。
线上再通过 A/B Test 验证真实工作负载,避免只在公开 Benchmark 上表现良好。
尤其需要关注长任务。单次调用成功率并不能代表 Agent 的最终成功率;上游步骤的错误可能传递给下游。因此评估必须以完整任务或 Thread 为单位,同时保留每个 Step 的明细。
八、推荐的落地路线
不建议一开始就训练一个专门的 Router,也不建议引入复杂的强化学习系统。
第一阶段:建立模型能力档案和 Trace。
记录每个任务的类型、每次模型调用、Token、成本、延迟、工具结果、重试次数和最终完成状态。没有这些数据,就无法判断哪些任务真正需要强模型。
第二阶段:实现规则 + Haiku Router。
先用规则处理确定性任务,再让 Haiku 对剩余请求进行三档分类。使用 Structured Output,限制输出范围,低置信度时选择安全默认值。
第三阶段:加入执行结果验证和升级。
对 Coding、SQL、Extraction 等任务使用确定性验证器。只有验证失败或出现明确的复杂度信号时,才升级到 Sonnet 或更强模型。
第四阶段:扩展到 Agent Step Routing。
Planner 为每个子任务分配模型等级,执行器在任务边界应用选择。不同子 Agent 可以使用不同模型,而不是整个 Thread 绑定一个模型。
第五阶段:用执行历史改进策略。
积累任务类型、模型选择、结果质量和成本,建立路由经验库。初期可以使用统计分析和阈值校准;有足够数据后,再考虑 RouteLLM 一类的学习型 Router 或 Context → Action → Feedback → Context 的在线优化机制。
九、手动选择模型,还是交给 Auto Router?
前面的讨论主要关注 Agent Runtime 如何实现自动路由。但在 VS Code Copilot 这样的开发环境里,还有一个现实问题:如果开发者已经熟悉 Haiku、Sonnet 等模型的能力,自己判断并切换模型,是否比 Auto 更划算?
答案不是简单的二选一。手动选择和自动路由解决的是不同层次的问题。手动选择利用开发者掌握的项目背景、业务风险和技术约束;Auto 则利用当前请求、可用模型状态以及平台掌握的任务信号,减少重复判断。
VS Code Copilot 的 Auto 已经不只是随机挑模型
截至 2026 年 11 月,VS Code Copilot 的 Auto 会根据请求的任务复杂度和模型可用性选择模型。GitHub 在 2026 年 5 月公布的改进还提到,路由会考虑推理需求、代码生成复杂度、Bug 诊断难度和工具编排需求,并尽量沿自然的 Prompt Cache 边界切换,避免不必要的缓存成本。
官方文档还明确提醒:在同一个 Session 中途频繁切换模型,可能增加成本,却没有带来足够的质量提升。这一点很重要——手动控制不应该被理解为每条 Prompt 都重新挑选一次模型。对于一个边界清楚的复杂任务,开始时选定 Sonnet 并持续完成,通常比在 Haiku、Sonnet 之间反复切换更合理。
VS Code 当前还需要区分 Auto 与 Fusion:
- Auto:根据每个请求的任务复杂度和可用性,选择一个模型。
- Fusion:不仅选择模型,还可以协调模型和工作流;例如让一个模型负责初稿,另一个模型负责审查。它更接近轻量级 Orchestration,而不只是单次模型路由。
参考:GitHub:Auto model selection now routes based on your task、VS Code:Compare and choose models for your coding tasks、GitHub Docs:Auto model selection。
手动选择和 Auto 各自擅长什么
手动选择的优势不是开发者一定比模型更会判断“任务难度”,而是开发者通常掌握了路由器看不到的上下文。例如:某个模块存在历史技术债、数据库迁移具有不可逆风险、一个看似简单的修改会影响多个下游系统,或者当前任务涉及尚未写入 Prompt 的架构约束。这些因素会改变错误代价,也会改变应该使用的模型等级。
但手动选择也有成本。开发者需要持续判断任务类型、了解模型版本和能力变化,并承担选择错误的代价。模型能力和可用性会变化,凭经验形成的固定映射也可能过时。对于大量简单、短小、频繁切换的请求,这种注意力成本很容易超过模型费用上的收益。
Auto 的优势是降低选择负担,并利用平台掌握的实时可用性和任务信号。它尤其适合一个 Session 中混合了代码阅读、局部修改、测试、解释和复杂推理的工作流。不过,Auto 只能利用它实际获得的上下文;未显式提供给它的业务风险、团队约束和项目历史,不会凭空进入决策。自动策略的权重和模型池也可能随平台更新而变化。
因此,对熟悉项目的资深开发者而言,手动选择在高影响、强领域约束的任务上仍然有价值;Auto 在日常混合任务和高频小任务上通常更省心。两者并不冲突。
有没有证明手动选择优于 Auto 的公开对照实验?
目前没有找到足够严格、公开且可复现的研究,直接比较“有经验的开发者有意识地手动选择模型”与“当前 VS Code Copilot Auto”,并且在相同代码库、任务、上下文、工具权限和质量评审标准下得出整体胜负。
现有证据需要正确解读:
- LangChain Open SWE 的 973 个 Agent Thread 实验,比较的是动态路由与始终使用 GPT-6 Astra 的固定强模型基线,不是与资深开发者手动选择模型比较。
- GitHub 对 VS Code Auto 的成本和质量改善描述属于官方产品说明,不能替代独立的受控对照实验。
- VS Code 提供的 Compare Models Preview 可以在隔离 Worktree 中,用相同 Prompt 并行运行多个明确指定的模型,并结合 Judge Model 比较正确性、可维护性、耗时和成本。但 Auto / Fusion 不能直接作为 Compare Models 面板中的一个候选模型,需要通过独立 Session 或 Worktree 另行比较。
VS Code 官方建议控制相同的起始 Commit、Prompt、Harness、Instructions、Tools 和 Permissions;评估时还要把 Review、Follow-up 和人工修正时间计入,而不能只看模型第一次生成用了多久。对于经常发生的任务,应重复多个有代表性的样本,不要用单个例子下结论。
如何在自己的开发工作中做一次有效比较
可以从日常项目中抽取 30–50 个真实任务,按简单修改、Bug Fix、多文件功能开发、重构、架构设计、Research 和复杂 Debugging 分层。每个任务固定起始 Commit、Prompt、AGENTS.md、Skills、MCP、工具权限和测试条件,再比较三组策略:
| 实验组 | 选择方式 | 代表的工作模式 |
|---|---|---|
| A:Manual | 开发者在执行前根据任务和项目背景选择模型 | 有经验的人工判断 |
| B:Auto | 使用 Copilot Auto,不人为干预模型选择 | 平台自动路由 |
| C:Hybrid | 默认 Auto;高风险或低置信度任务由开发者 Override | 人机协作路由 |
A 组的模型选择应在查看其他组输出之前完成,避免被结果反向影响。C 组则要记录人工介入次数和选择所花时间,否则会低估 Hybrid 的成本。
重点比较完整任务的成功率、最终质量、Review 与修正时间、AI Credit / 模型成本、端到端耗时、重试次数和失败恢复成本。最终成本应包含模型调用、人工审查和返工,而不是只比较 Token 价格。任务之间差异较大时,应采用配对比较:同一个任务分别运行各组策略,再汇总不同任务类型的结果。
实际使用建议:不要把手动切换变成新的工作负担
对于个人开发者,我建议把 Auto 作为日常默认入口,而不是每次都手动选择模型。明确的小修改、格式整理和简单测试可以使用 Haiku 或 Efficiency;跨模块实现、复杂 Debugging、重构和架构决策,可以主动指定 Sonnet 或更强模型;涉及高风险数据库、基础设施或不可逆操作时,模型选择之外还应增加独立验证和权限约束。
更重要的是按任务边界选择,而不是在同一个长任务里频繁切换。比如一个重构任务从理解代码、制定方案到修改和测试,若这些步骤共享大量上下文,固定一个足够胜任的模型可能比不断切换更经济。只有当任务阶段发生实质变化,或者执行结果暴露出能力不足时,才考虑切换或升级。
对于企业 Agent Platform,建议把这种关系明确实现为 Human Policy + Auto Routing + Human Override:人定义允许使用的模型、预算、质量底线和风险边界;Router 处理常规任务;高风险、低置信度或超出策略边界的任务才触发人工覆盖。人工控制的是策略和风险,而不是每一次模型调用。
最终建议
我建议把 Auto Router 作为 Agent Runtime 的一个独立组件,而不是一个简单的模型选择函数。
第一版采用:
- Rule-based Router 处理确定性任务;
- Haiku 或专用 Decision Model 负责常规分类;
- Sonnet 处理高不确定性和复杂规划;
- Opus / Frontier 只处理确实需要更高推理能力的任务;
- Verifier 决定是否接受结果或升级;
- Trace 与 Eval 记录每次决策及其实际收益。
后续重点从 Thread-level Routing 发展到 Step-level Routing,并把执行结果反馈给 Router。
最重要的原则是:选择模型的依据不是哪个模型最强,而是哪个模型以最低的完整任务成本,能够稳定达到质量要求。
这才是 Agent Runtime 应该具备的 Auto Routing 能力。
参考资料
论文
- RouteLLM: Learning to Route LLMs with Preference Data
- FrugalGPT: How to Use Large Language Models While Reducing Cost and Improving Performance
- LLMRouterBench: A Massive Benchmark and Unified Framework for LLM Routing
- Planner-as-Router: Joint Plan-Time Model Routing for Cost-Efficient Multi-Agent Workflows
- AgentRouter: Heterogeneous Model Routing for Cost-Optimal Multi-Step Agentic Workflows
- Agent-as-a-Router: Agentic Model Routing for Coding Tasks
- HM-Router: Joint Model and Harness Routing for Agentic Systems