Bridgewater Vault 架构复盘:Document Lake、三种检索主栈与 Turbopuffer
Bridgewater Vault 的公开案例适合用来讨论一类企业系统:把外部数据、内部研究材料和会议记录放进同一个资料库,再让研究员和 Agent 按时间、来源、资产和权限检索证据。难点不只是找到相似文本,还包括材料来源、版本、授权范围,以及命中后能否回到原始证据。
本文从 Vault 公布的规模和负载入手,先梳理文档事实层与检索索引的边界,再比较 Snowflake、PostgreSQL 和 OpenSearch 三种实现。Embedding 的模型和费用、Turbopuffer 的上游文档处理、对象存储原生检索的技术路线,放在相应的设计问题下讨论。
1. Vault 的负载画像:规模、过滤条件与 Agent 并发
参考文章介绍了 Bridgewater 的 Vault。它接入超过一亿份文档、135 个外部数据来源和内部研究记录,每天继续增加数千份文档。文档需要关联国家、市场、概念、来源和讨论时间,投资者与 Agent 都通过同一套平台检索证据。Bridgewater:一亿份文档背后的 AI 投研系统
这个案例的重点不在文档数量本身,而在检索条件和使用方式。投资问题通常包含明确的时间范围、资产、国家或来源条件。演讲中展示的韩元问题,需要把查询限定在某一周内;Vault 返回 52 份候选材料,最终引用其中 7 份。开放网络检索则依赖了时间较早的材料,无法准确反映提问时的市场共识。
Bridgewater 还介绍了一个很实际的检索质量问题:团队先建立约 200 条人工评测样例,最初前十条结果的准确率约为 60%,经过多项检索改进后,讲者报告提升到约 90%—95%。这些数字是演讲者对内部评测的描述,不是独立基准测试,但这组数据更重要的启示是:检索平台需要自己的评测集,不能用模型对答案的信心代替检索质量。
人和 Agent 对检索系统的压力也不同。演讲中描述的人类使用量约为每小时 100 次查询;Agent 查询轻易超过每秒 100 次,集群场景可能达到每秒数千次。前者更在意首屏结果准确率,后者需要高召回、吞吐和稳定的过滤性能。两种工作负载共用一套知识库是合理的,但不能只用人工交互的流量模型来估算容量。
2. Turbopuffer 的设计取舍:检索能力与存储架构
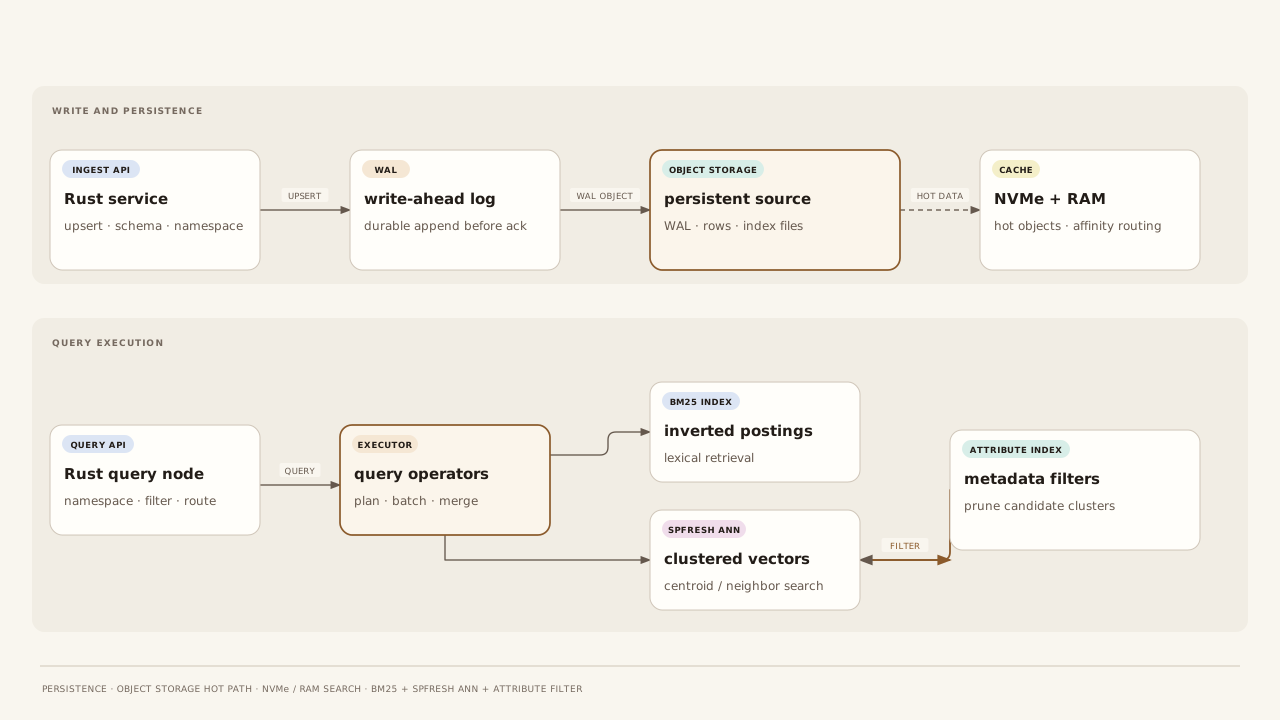
Turbopuffer 的架构可以拆成三个相互依赖的部分。
第一层是对象存储优先的持久化模型。对象存储作为持久数据层,写入日志、数据和索引被组织成适合远端读取的结构。查询节点使用内存与 NVMe 缓存热点数据,冷数据仍可从对象存储读取。它的设计目标是让计算节点可以扩缩,而不必把完整数据集长期固定在每台机器的本地磁盘上。Turbopuffer Architecture
第二层是向量索引和属性索引之间的协作。Turbopuffer 的 Native Filtering 并非先运行一次普通向量搜索,再简单地从 Top-K 结果里删除不符合过滤条件的记录。它会利用属性索引判断哪些向量簇可能包含符合条件的文档,再把搜索范围集中到这些簇。这是它在高选择性过滤下仍能保持召回率的关键设计之一。Native filtering for high-recall vector search
第三层是统一的检索 API 和查询执行。BM25、向量、属性过滤、聚合等能力共享底层数据和索引体系。它减少了不同检索系统各自维护数据副本、权限和生命周期的负担。
所以,模仿 Turbopuffer 至少有两个目标,不能混为一谈:
| 目标 | 需要做到什么 | 现有基础设施能否覆盖 |
|---|---|---|
| 检索能力接近 | BM25、ANN、Hybrid、过滤、权限和多租户 | 可以,主要由 OpenSearch 提供 |
| 存储和计算架构接近 | 对象存储作为持久事实来源、远端友好索引、缓存、无状态查询 | 只能部分实现,需要额外设计和验证 |
检索能力可以通过产品组合获得;对象存储优先的持久化、索引布局和无状态查询,则需要搜索引擎本身支持。增加数据库数量并不能自动得到这些特性。
2.1 推荐组合与 Turbopuffer 的差距
| 能力 | 推荐组合 | Turbopuffer |
|---|---|---|
| 原始文档持久化 | S3 / R2 | 对象存储为持久化基础 |
| 全文和向量检索 | OpenSearch | 统一查询引擎 |
| 属性过滤 | OpenSearch filter + ACL 约束 | 与向量索引协同的 Native Filtering |
| 事务和租户元数据 | PostgreSQL | 内建 Namespace / 文档模型 |
| 历史分析 | Snowflake | 主要面向检索服务 |
| 冷热缓存 | OpenSearch 节点缓存 + 自建缓存策略 | 内存和 NVMe 分层缓存 |
| 计算与存储解耦 | Remote Store 可部分实现 | 对象存储优先的存储引擎 |
| 索引重建 | 外部快照、批次清单和 alias 切换 | 服务自身管理 |
底层实现:自研的对象存储原生引擎
公开资料显示,Turbopuffer 的查询进程是 Rust binaries,服务节点访问对象存储中的数据库数据;每个 Namespace 有独立对象存储前缀,写入先追加 WAL 文件,成功响应意味着数据已经持久化到对象存储。随后索引异步构建,尚未进入索引的数据仍可通过较慢的扫描路径查询。NVMe SSD 和内存保存热点数据,查询节点可以为 Namespace 做缓存亲和路由,但节点本身不是唯一数据副本。Turbopuffer Architecture Turbopuffer Concepts
它的索引选择也与 PostgreSQL 和 OpenSearch 不同。向量 ANN 基于 SPFresh 的中心点聚类索引,而不是 HNSW 或 DiskANN 图;这种组织方式把查询集中到若干向量簇,减少对象存储的随机往返和写放大。全文检索是针对对象存储设计的倒排 BM25 索引,属性过滤还有自己的倒排/精确索引,并且知道向量聚类的组织结构,能协助高选择性过滤下的 ANN 搜索。WAL、ANN、BM25、Attribute Index 和冷热缓存共同构成它的数据库内核。Turbopuffer Architecture
从版本演进可以更清楚地看到它不是传统搜索集群的简单托管。v1/v2 以向量地址和聚类布局作为主要索引基础,其他查询能力围绕这个向量优先的数据布局扩展;官方在 v3 设计说明中明确指出,这种做法带来了存储放大、写放大和查询向量化受限的问题,因此开始把 ANN 从主索引改成二级索引。v3 公布的方向是列式、Struct-of-Arrays 数据布局,利用 Constant、Dictionary、RLE、Frequency 等编码压缩属性,并让查询算子直接在压缩数据上执行;查询执行也改为向量化流水线。这些属于官方公开的 v3 设计和演进信息,不应被误读为 PostgreSQL 的表存储或 Lucene 的 Segment 实现。Turbopuffer v3: RIP, vector database Turbopuffer v3 development log Fully vectorized query execution
据此可以判断:Turbopuffer 的核心是自研的分布式检索与存储引擎,公开架构使用 Rust 服务、对象存储持久化、WAL、SPFresh ANN、BM25/属性索引、NVMe/内存缓存和自有查询执行器。它不是 PostgreSQL 加 pgvector,也不是 OpenSearch/Lucene 集群换了一个 API。公开资料没有完整披露它内部每一个低层库或存储文件的实现,因而不能进一步断言完全没有借用第三方组件;但没有证据支持把 PostgreSQL 或 OpenSearch 视作其底层核心。
OpenSearch Remote Store 是重要的演进方向。Remote-backed storage 可以把 translog 和 Lucene segment 持久化到 S3、GCS 或 Azure Blob;使用 segment replication 时,副本可以从共享远端 segment store 获取数据,减少主分片向副本直接复制文件的负担。OpenSearch Remote-backed storage
但它仍然是 OpenSearch 的分片存储架构。节点恢复、分片分配、查询节点本地资源和远端文件缓存仍然需要集群管理。它提升了数据耐久性和复制方式,并不自动把 OpenSearch 变成可随时销毁的无状态查询层。
成本上也有类似的差距。OpenSearch 集群仍需要为分片、索引段、查询缓存、写入合并和副本保留计算与本地存储资源。S3 快照或 Remote Store 可以降低部分持久化成本,但不会自然带来 Turbopuffer 那种按热点数据缓存、冷数据远端读取的完整经济模型。
3. 文档事实层:Document Lake、Catalog 与可替换索引
系统真正需要稳定的是文档身份、版本、来源、权限和处理结果。PostgreSQL、OpenSearch、Snowflake 都是实现选择,应通过接口隔离。对象存储保存内容和派生工件,Document Catalog 管理业务状态,处理流水线生成版本化产物,检索系统维护面向查询的索引投影。
3.1 四个职责边界
| 层 | 保存或管理什么 | 设计约束 |
|---|---|---|
| Object Storage | 原始文件、规范化文本、页面图片、表格、Chunk、Embedding、清单和快照 | 按文档版本组织;对象可校验、可恢复、可迁移 |
| Document Catalog | Document、Version、Asset、ACL、来源、关系、处理状态、索引水位 | 业务身份和权限的权威来源;通过 API 暴露 |
| Processing | 文件解析、OCR、版面理解、切分、分类、实体抽取、Embedding | 每个产物记录 Parser、Pipeline、Schema 和 Model 版本 |
| Search / Analytics | BM25、ANN、Hybrid Search、SQL、聚合和评测 | 只保存查询投影;允许重建和替换 |
Document Catalog 不应等同于 Glue Catalog 或 Iceberg Catalog。前者需要理解一份文档的业务身份、版本、来源、附件、ACL、保留策略和派生资产;后者主要管理分析表、Schema、Snapshot、Manifest 与数据文件。两者可以通过 Document ID 和数据集清单关联,但不应强行合并。
Catalog 的第一版可以用 PostgreSQL 实现,因为它擅长事务、关系和唯一约束;但业务接口不应该暴露 PostgreSQL 表结构。后续可以把分析数据投影到 Iceberg,由 REST Catalog 提供跨引擎访问。这样 PostgreSQL 是实现选择,不是系统边界。
3.2 文档、版本与派生资产
一个逻辑 Document 可以有多个 DocumentVersion,每个版本又有多个 Asset。比如一份研究报告会同时产生原始 PDF、解析后的 Markdown/JSON、页面图像、表格数据、Chunk、Embedding 和摘要。它们都应通过 Catalog 中的关系追溯到原始版本。
推荐的逻辑对象布局如下。实际 Bucket 和 Key 可以根据租户、保留策略及成本分层调整,业务代码不要依赖目录层级:
document-lake/
  raw/{document_id}/{version_id}/original.pdf
  normalized/{document_id}/{version_id}/document.md
  extracted/{document_id}/{version_id}/pages/
  extracted/{document_id}/{version_id}/tables/
  extracted/{document_id}/{version_id}/images/
  chunks/{document_id}/{version_id}/{pipeline_version}/chunks.parquet
  embeddings/{document_id}/{version_id}/{model_id}/vectors.parquet
  manifests/{document_id}/{version_id}/manifest.json
原始文件不可被解析器覆盖。解析器、切分策略或模型升级时,生成新的派生版本,并记录 source_document_id、source_version_id、pipeline_version、parser_version、model_id、schema_version、checksum 和生成时间。Embedding 是派生工件,不是文档本身;从 OpenAI 模型切换到自部署模型,只应重算对应的向量产物和索引。
Document ID 是业务身份,Object Key 是存储定位符。应用通过 Catalog 获取对象位置,不拼接 S3 路径。这样迁移到 R2、MinIO、Ceph、Garage 或其他 S3-compatible 存储时,不必改变文档模型。需要注意,S3 API 兼容不代表对象锁、版本控制、条件写入、事件通知、生命周期和权限语义完全相同,存储适配层必须有能力测试。
3.3 Document Catalog 的最小模型
| 实体 | 责任 |
|---|---|
| Document | 稳定的逻辑文档身份 |
| DocumentVersion | 不可变的来源版本、时间和内容校验和 |
| Asset | 原件、解析文本、图片、表格、Chunk 文件等具体对象 |
| Chunk | 文本片段及页码、段落、坐标和来源位置 |
| Entity / DocumentRelation | 人物、机构、市场、证券及文档间引用关系 |
| Source | 来源系统、连接器、外部 ID、同步水位 |
| ProcessingRun | 解析、OCR、抽取、Embedding 等任务及其输入输出版本 |
| AccessPolicy | 文档权限、继承关系、保密级别和授权主体 |
| IndexManifest | 索引名称、后端、版本、模型、完成水位和切换状态 |
Catalog 保存权威 ACL,搜索索引只保存查询所需的权限投影。查询时必须执行授权检查;撤权不能只依赖异步索引刷新。对高敏感数据,应该支持 Catalog 侧的即时 deny、候选结果二次校验和权限版本水位。索引延迟与权限传播延迟要分别监控。
3.4 摄取、处理和索引的生命周期
文档上传先落对象存储,再登记 DocumentVersion、Asset 和待处理事件。Worker 通过幂等任务完成解析与派生工件写入,Catalog 记录 ProcessingRun 和 Manifest。索引 Worker 消费已发布的工件,分别写入全文、向量或分析后端。每个后端独立维护索引水位;全部或指定关键索引完成后,文档版本才达到相应的可检索状态。
| 步骤 | 输入与处理 | 输出和状态 |
|---|---|---|
| 1. Ingest | 来源连接器接收 PDF、Office、邮件、网页和结构化数据 | 原始对象写入 Object Storage;Catalog 登记 DocumentVersion |
| 2. Process | Worker 执行解析、OCR、表格/图片提取、分类和实体抽取 | 规范文本、页面资产、表格和处理 Manifest |
| 3. Derive | 按版本化策略切分 Chunk,并按需生成 Embedding | Chunk/Embedding 等派生工件写入对象存储 |
| 4. Index | Search Adapter 将文本、向量、元数据和 ACL 投影到不同后端 | BM25、ANN、Hybrid 等索引水位分别更新 |
| 5. Analyze | 将标准化数据和事件投影到 Iceberg 或 Snowflake | 治理、统计、历史分析和检索评测数据集 |
| 6. Query | Catalog API 提供身份、版本和权限;Search API 路由检索 | 应用和 Agent 获得可追溯、经过授权的证据 |
消息队列可以按现有平台选择,但事件必须可重放,处理必须幂等,产物需要版本化,索引水位也要可观测。搜索后端发生故障时,可以从 Manifest 和工件重新构建;切换后端时,也不需要重新抓取原始来源。
3.5 总体架构与在线查询
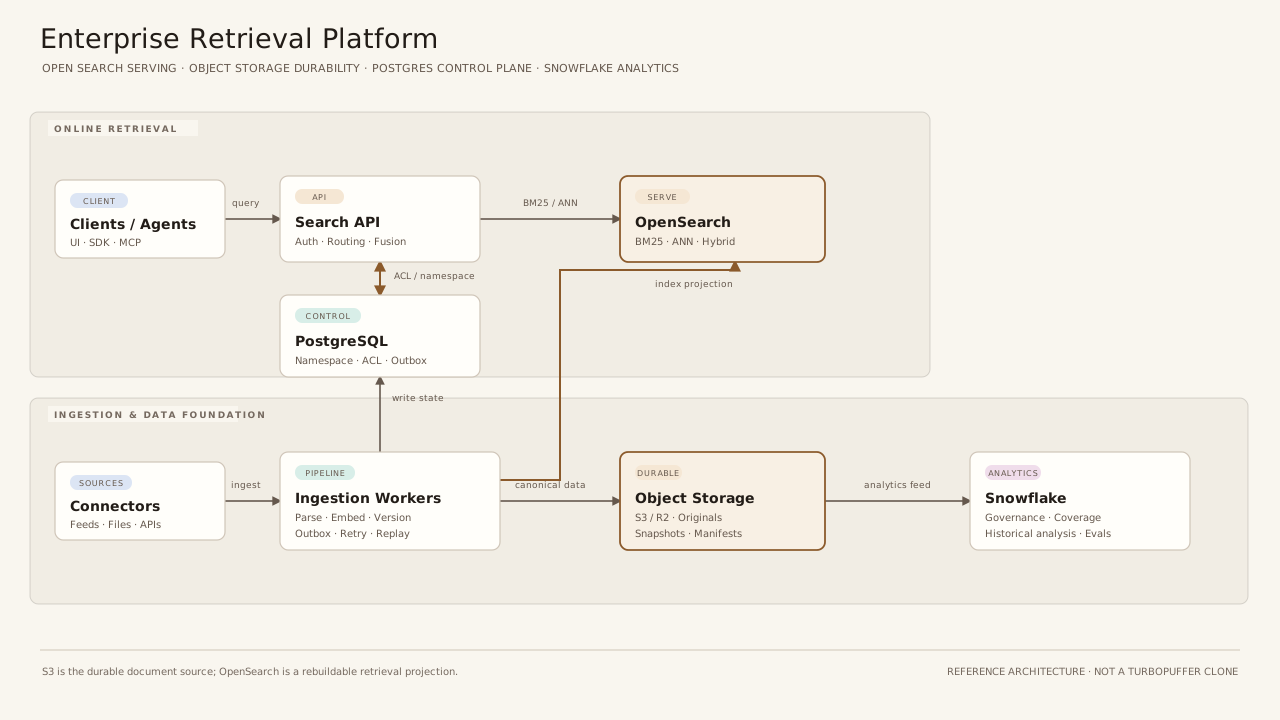
整体架构将在线检索与文档摄取分开。检索请求只访问 Search API、PostgreSQL 控制面和 OpenSearch;文档摄取则经过 Outbox、索引 Worker 和对象存储。Snowflake 消费标准化数据和检索事件,用于分析而不进入每一次在线查询。
在线查询路径
Search API 完成身份验证、租户识别、查询解析和权限条件构造。它从 PostgreSQL 获取 Namespace 与 ACL 元数据,再把租户、用户组、来源、时间和业务标签等条件推送到 OpenSearch。OpenSearch 执行 BM25、ANN 或 Hybrid Search,返回候选文档和排序分数。必要时再由检索层执行 RRF、分数归一化或轻量 Rerank。
权限条件必须进入检索过程,不能先全局搜索再在应用层随意删掉不允许访问的结果。对于高敏感数据,可以在返回前用 PostgreSQL 中的权限版本再次核对候选 ID;为了避免过滤后结果数量不足,需要适度 over-fetch,并将权限更新延迟纳入评测。
3.6 结构化与非结构化数据处理流程
三种主栈并非同一张图的简单换名。Snowflake 将目录、表变换和托管检索放在同一数据平台;PostgreSQL 把目录、权限、事务和检索组合进 SQL;OpenSearch 则把在线全文、向量和过滤查询作为核心,原始文档和业务目录仍由外部系统负责。三种主栈的独立架构图放在第 4 节,分别标出数据处理、索引构建、查询授权和证据回取的责任边界。
三种方案共用一条业务生命周期,但结构化与非结构化内容的摄取方式不同。结构化源通常通过 CDC、API 或批量数据接入,重点是 Schema、主键、单位、时间语义和数据质量;非结构化源先保存原件,再解析版面和正文,扫描件需要 OCR,会议录音需要 ASR,随后执行规范化、实体识别、权限映射和语义分块。两路数据在 Document Catalog 和检索投影处汇合。下面的流程图展示从入库到证据回传的完整链路。
3.7 Palantir Foundry:相似的分层思想
Palantir 的公开文档给出了很直接的证据。Foundry Dataset 被定义为一组文件的逻辑包装,支持结构化、半结构化和非结构化内容;文件本身不一定存放在 Foundry 服务内部,而是通过逻辑路径映射到 backing filesystem。官方文档称这个底层文件系统可以是自建 HDFS,但更常见的是云存储,例如 Amazon S3。Foundry Datasets
对于非结构化内容,Foundry 另有 Media Sets,面向大规模图片、音频、视频和文档,提供适配媒体处理的存储、计算和转换工作流。例如可以通过 Pipeline Builder 从 PDF 中提取文本。Foundry Media Sets
再往上,Foundry Ontology 把数据源映射成业务对象、属性和关系,并把数据、逻辑、动作和安全策略组合起来。它不只是一个 Data Catalog,也不是简单的知识图谱,而是供应用和 Agent 使用的业务操作模型。The Ontology System
Palantir 还公开了 Ontology 后端的架构演进:Object Storage v2 将原先集中在一个子系统中的索引、查询和数据职责进一步拆开,使索引与查询能够独立扩展。这与本文强调的“事实存储、索引投影、查询服务分离”方向一致。Ontology Backend Architecture
因此,可以回答:是的,Palantir 确实构建了与此相近、而且覆盖范围更大的企业数据底座。 但不能据此推断其所有客户部署都使用 S3,也不能把 Foundry 内部实现等同于公开的 S3 + PostgreSQL + OpenSearch 组合。Palantir 的文档只披露了部分架构和抽象,核心平台是专有产品。它真正值得借鉴的不是某个具体数据库,而是 Dataset/Media Set 的内容组织、Ontology 的业务语义层、统一安全模型,以及索引和查询服务的职责分离。
3.8 可借鉴的开源项目
| 项目 | 与 Document Lake 的匹配点 | 主要差异与评估 |
|---|---|---|
| Autofile | S3-compatible 对象存储保存文件,PostgreSQL 保存元数据和搜索索引;OCR、文档分类、自定义元数据和全文搜索 | 架构最接近本文提出的轻量底座,但项目明确标注 Alpha。适合研究实现和做小规模 POC,不应直接当作亿级生产系统 |
| FormKiQ Core | API-first 文档服务;S3、元数据、标签、搜索、版本、事件、访问控制、OCR;支持 AWS 部署和本地 Docker | 企业文档管理能力较完整,MIT 许可;架构明显偏 AWS,核心依赖 S3、DynamoDB、Lambda/API Gateway 等服务。适合 AWS 内落地,不是跨云中立 Catalog |
| NemakiWare | CMIS 文档仓库、文档版本和关系、继承 ACL、全文与向量混合检索、MCP;支持 S3 冷归档 | 更像可直接使用的文档仓库。当前主要使用 CouchDB + Solr,默认部署是单副本;要做大规模分布式系统,需要单独验证扩展与运维边界 |
| Pansoph | 将 Connector、Parser、Embedder、VectorStore、Authz、ObjectStore 等抽象为可替换 Port,强调文档级权限 | 架构抽象与避免技术栈绑定的目标高度一致,但项目较新,默认组合仍包含 PostgreSQL、Qdrant、SpiceDB、Garage/SeaweedFS 等多个服务;需要验证代码、测试和生产成熟度 |
| RAGFlow | 复杂文档解析、Chunking、知识抽取、检索和 Agent/RAG 工作流 | 更偏完整 RAG/知识处理平台,不是中立的文档事实存储和 Catalog。可以借鉴处理流水线,不建议让它成为唯一原始文档仓库 |
这些项目的定位差异很大。Autofile 和 FormKiQ 更接近“文件 + 元数据 + 文档处理”;NemakiWare 更接近“权限感知的文档仓库”;Pansoph 更强调模块化和可替换适配器;RAGFlow 的强项是文档理解和检索工作流。没有必要为了复用其中一个项目而接受它的全部存储和检索栈。更现实的做法是先评估它们的数据模型、API、ACL 和对象存储适配方式,再决定复用服务还是只借鉴设计。
另外,OpenMetadata 和 DataHub 这类数据 Catalog 主要管理数据集、表、Schema、Owner、Lineage 和治理信息,不能直接替代文档级内容仓库。Iceberg Catalog 管理分析数据集,也不负责 PDF 的版本、附件、Chunk 和逐文档权限。选型时必须区分 Data Catalog、Document Catalog 和 Search Index。
4. 三种主栈的实现与取舍
Snowflake、PostgreSQL 和 OpenSearch 都能承载检索,但它们把事务、元数据、全文索引、向量搜索和分析放在不同位置。下面分别看每种方案的实际边界。
4.1 Snowflake:治理和分析统一,检索容量需要先验证
Snowflake 可以作为 Vault 类平台的主栈。文档目录、Chunk、来源、实体、权限和版本都保存在 Snowflake 表中,Streams、Tasks、Dynamic Tables 或 Snowpipe 负责持续摄取与变换,Cortex Search 提供关键词、向量和混合检索。对于已经把研究数据和分析工作负载集中在 Snowflake 的机构,这种方式可以减少平台数量,让搜索与数据治理共享一套数据模型。
架构设计
| 层次 | 组件与职责 | 设计要点 |
|---|---|---|
| 来源接入 | 外部数据连接器、内部研究系统、文件导入 | 为每个来源维护 connector、增量水位、凭证引用和失败重试 |
| 原始数据 | S3 / Snowflake Stage | 保存原始文件、来源 URI、checksum、版本和批次清单;搜索索引不作为原件归档 |
| 规范化数据 | Snowflake Raw、Document、Chunk、Entity、ACL 表 | 每个 document 和 chunk 使用稳定 ID;显式记录 document_version、embedding_version 和解析版本 |
| 数据处理 | Snowpipe、Streams、Tasks、Dynamic Tables、外部解析 Worker | 完成解析、去重、分块、实体归一化、Embedding 计算和增量物化 |
| 在线检索 | Cortex Search | 正文作为搜索列,tenant、来源、国家、市场、概念、时间和安全域作为 ATTRIBUTES |
| API 与治理 | Search API、Snowflake 角色体系、审计与评测表 | 后端代理查询,强制注入权限过滤;保存查询 Trace 和人工相关性标签 |
连接器收到新材料后,先把原件写入 S3,再把来源元数据和对象 URI 写入 Snowflake。解析 Worker 根据文件版本生成规范文本和 Chunk;Embedding 可以由 Cortex Search 管理,也可以由外部模型计算后写入表。Cortex Search 从版本化的 Chunk 表构建索引,Search API 通过服务端身份验证用户,再将租户、安全域、时间区间、来源和市场条件作为过滤器传给 Search Service。返回的 chunk_id 用于从 Snowflake 或 S3 取回完整证据片段和原文。
Cortex Search 已提供关键词和向量召回,并在 Hybrid 模式下进行语义重排;评分配置还可以结合字段权重、时间衰减等因素。这样,团队不必自己维护两套召回引擎和一套融合服务。Cortex Search Overview
增量刷新不等于同步写入
Cortex Search 的来源是一个查询结果集。可以指定 PRIMARY KEY,让刷新过程识别变化行并使用增量路径;但底层对象需要满足 Change Tracking 等条件,源查询结构也会影响增量刷新是否可用。没有稳定主键或不适合增量刷新时,索引构建和更新成本会更高。CREATE CORTEX SEARCH SERVICE
TARGET_LAG 表示 Search Service 内容相对源数据的目标延迟,不是写入 Snowflake 表之后立刻可检索的强一致承诺。若 Agent 刚上传了一份研究材料就立即查询,API 应该暴露索引状态或 indexed_version 水位,而不能把表写入成功当成 Cortex Search 已经包含该版本。ACL 撤权也有同样的问题:授权数据变化与搜索索引刷新之间存在传播窗口,必须定义业务可接受的窗口,并准备紧急撤权路径。
亿级文档和 Agent QPS 的容量门槛
Snowflake 当前 Cortex Search 文档列出的默认限制需要与 Vault 的负载画像直接对照:单个 Search Service 的物化查询结果应低于 400M 行;超过该行数,创建查询会失败,需要联系 Snowflake 提高上限。默认速率限制为每个 Search Service 20 QPS、账户内所有服务合计 140 QPS;发生限流时客户端会收到 429,需要退避重试。更高额度要由客户与 Snowflake 确认,不能把默认限制当成可自动扩展的容量。Cortex Search known limitations
这和 Bridgewater 公开演讲中 Agent 查询超过 100 QPS、集群场景可能达到数千 QPS 的描述存在明显差距。一亿份文档也不等于一亿行搜索记录:如果每份文件平均拆成四个 Chunk,就已经接近 400M 行;更细粒度的 Chunk 会更早触及行数上限。这个估算只是容量推演,不是对 Vault 实际 Chunk 数的判断。POC 应先用实际 Chunk 分布核实物化行数,并要求 Snowflake 对目标 QPS、突发流量、服务数量、索引刷新和 SLA 给出明确答复。
水平扩展也不能简单理解成多建几个 Search Service。服务数增加可能绕过单服务的部分限额,却不能绕过账户级默认 QPS 限额;拆分服务还会把查询路由、跨服务去重、权限一致性和聚合融合的责任交还给应用。若把数据按国家、市场或租户拆成几十个服务,查询可能变成扇出请求,延迟和结果合并复杂度也会增加。
Owner’s rights 带来的权限设计
Cortex Search 使用服务所有者权限查询来源数据。官方文档明确指出,获得 Search Service 查询权限的角色可能检索到服务所索引的全部内容,即使该角色对底层源表没有相应 SELECT 权限;底层表的 Row Access Policy 和 Masking Policy 不应被当作 Search Service 的逐用户授权控制。Query a Cortex Search Service
因此,不能把 Search Service 直接暴露给浏览器或不可信 Agent。建议只给后端 Search API 授予 USAGE,API 根据用户身份和组成员关系生成不可被请求参数覆盖的 ATTRIBUTES 过滤条件,并记录实际执行的过滤器。对高度隔离的数据域,可以拆分服务和服务所有者角色;但拆分粒度应按真实的安全边界决定,不能每个用户一个服务。ACL 更新必须有传播监控、撤权补偿和审计证据。
成本和适用边界
Cortex Search 的成本包括刷新源查询所使用的 Warehouse、文档变化时计算 Embedding 的 Token,以及按未压缩索引数据 GB/月计费的 Serving Compute。Serving Compute 在服务可用期间持续计费,并不只在收到查询时产生;大量文档或频繁更新会把索引和 Embedding 成本推高。Cortex Search costs
Snowflake 主栈最适合数据本来就在 Snowflake、查询量中等、刷新延迟有余量、希望以托管方式获得 Hybrid Search 的组织。它的主要优点是数据治理、SQL 分析和检索服务统一,运维负担低;主要缺点是默认 QPS/行数限额、owner’s rights 权限边界和持续 Serving Compute 成本。对 Vault 公布的高并发 Agent 负载,Snowflake 仍然可以进入候选,但应先完成限额协商、权限威胁建模和成本压测,不宜按默认配置直接承诺生产容量。
4.2 PostgreSQL:事务与关系查询完整,搜索扩展由团队负责
PostgreSQL 主栈把文档目录、Chunk、权限关系、全文索引和向量索引尽量放在同一个数据库中。它的核心吸引力在于,文档版本、ACL 变更和索引任务状态可以在单一事务边界内维护;检索请求也可以在 SQL 中组合全文、向量和关系过滤。这种方案适合检索与复杂关系查询紧密耦合、数据库团队有能力承担分片和索引维护的组织。
架构设计
| 层次 | 组件与职责 | 设计要点 |
|---|---|---|
| 数据接入 | Connectors + Kafka / MSK / SQS | 管理 135 类来源的增量同步、削峰和事件回放 |
| 原始数据 | S3 | 保存原件、规范化快照、版本清单和解析产物 |
| 元数据与事务 | PostgreSQL | Document、DocumentVersion、Chunk、Source、Entity、Tenant、ACL 和 Outbox |
| 全文检索 | PostgreSQL FTS / VectorChord-BM25 | GIN/tsvector 适合基础全文;对 BM25 需求评估 VectorChord-BM25 与 tokenizer |
| 向量检索 | pgvector 或 VectorChord | pgvector 生态成熟、起步简单;VectorChord 提供量化和更丰富的索引路径 |
| API 与排序 | SQL + Search API | 服务端生成租户和 ACL 过滤;融合全文与向量候选,再做 RRF / rerank |
| 扩展 | Read Replica、分区、Citus 或应用分片 | 先压测单节点边界,再按明确的 shard key 扩展 |
文档进入系统时,原件先保存到 S3。PostgreSQL 事务写入文档版本、来源元数据和 Outbox 事件。Worker 从消息队列读取任务,完成解析、分块和 Embedding 生成,再批量写入 Chunk 表与向量字段。由于业务状态和 Outbox 处于同一事务,应用不会遇到“文档状态已更新但没有可靠索引任务”的双写窗口。向量索引本身仍可能异步更新,因此要区分业务事务提交和该版本真正可被 ANN 查询的时间。
Chunk 可以用 tenant_id、namespace_id、document_id、version、source_id、published_at、country、market、concept、security_scope、acl_principals 等字段建模。全文检索可以先用 tsvector + GIN 完成;若需要 BM25 评分和更完整的 Hybrid Search,可以评估 VectorChord-BM25。Dense vector 由 pgvector 或 VectorChord 承担,最终在 SQL 或服务层把两路候选用 Reciprocal Rank Fusion 合并。VectorChord 文档提供了稠密向量与 BM25 的混合检索用法,但它属于扩展生态,升级兼容性和生产支持应单独验证。VectorChord Hybrid Search
权限和事务是一项明显优势
PostgreSQL 的关系模型可以自然表达用户、组、租户、文档和 ACL 之间的多对多关系。检索 SQL 可以把授权条件作为 join 或 filter 执行。Row-Level Security 还能对数据库访问提供额外约束,但要正确设置连接角色:表所有者通常绕过 RLS,具有 BYPASSRLS 的角色也会绕过策略;必要时对表启用 FORCE ROW LEVEL SECURITY,并确保应用连接身份不是高权限管理角色。PostgreSQL Row Security Policies
与独立搜索引擎相比,权限表更新和文档元数据更新可以在同一个数据库事务里提交。需要注意,外部向量 Worker 和异步索引任务仍然会引入可检索性延迟;事务原子性并不意味着向量索引已同步完成。若使用外部 Embedding 服务,生成失败、模型版本变化、重复任务和乱序事件仍需要通过 Outbox、幂等键和版本控制处理。
向量数据体量与过滤召回
容量规划不能只看文件数。以 768 维 float32 向量估算,一条向量仅数值本身约 3 KB;一亿个 Chunk 的原始向量数据约 307 GB,尚未包括 HNSW/IVF 索引、Chunk 正文、元数据、WAL、缓存和副本。若一亿份文档平均产生多个 Chunk,向量规模还会进一步扩大。量化可以降低存储和内存压力,但需要用同一评测集衡量 Recall@K 损失,而不能只看压缩倍数。
pgvector 的近似索引过滤行为是重要限制。HNSW/IVFFlat 会在索引扫描中先取得候选,再应用 SQL 过滤;过滤条件选择性高时,最终结果可能少于所需 K。pgvector 的 iterative index scans 可以继续扫描来补足结果,但会受到 max_scan_tuples 或 max_probes 等上限约束。官方还建议根据过滤条件分布使用 Partial Index 或分区;共享的多租户 ANN 索引也可能因为不同租户的数据分布而影响彼此的召回和查询速度。pgvector Filtering
因此,需要把 tenant_id、安全域和高频 corpus 条件纳入查询设计。只有少数稳定租户时,可以考虑 Partial Index;租户很多时,可能要按租户组或安全域分区,避免每个小租户都创建一个物理分区。对 ACL 很复杂、选择性变化大的检索,要测过滤后的 Recall@10、有效结果数与 p95,而不能只用不带过滤的 ANN benchmark。
从单节点扩展到分片
单 PostgreSQL 主库加只读副本是合理的第一步,但只读副本扩展不了写入和索引构建能力。批量导入、向量重建、VACUUM、WAL 归档和在线查询会竞争同一套 CPU、内存和 I/O;应隔离长事务与批处理,监控复制延迟,并通过连接池、查询超时和 PITR 演练控制故障面。
当单节点成为瓶颈时,分区可以帮助索引局部化、生命周期管理和 partition pruning,但 PostgreSQL 原生分区仍然运行在一个数据库集群里,不会自动分散 CPU 和内存。Citus 或应用层分片可以把数据分到多个节点,不过必须让高频查询携带 shard key。按 tenant_id 分片可以让单租户查询定位到较少节点,但跨租户搜索需要扇出、候选合并和全局排序;热点租户还可能使 shard 分布失衡。pgvector 文档列出了 Citus 等水平扩展路径,但如果使用 VectorChord,必须验证所选扩展版本与分布式部署方式的兼容性,不能默认所有 PostgreSQL 扩展都能透明运行在分片集群中。pgvector Scaling PostgreSQL Table Partitioning
优缺点与适用判断
PostgreSQL 主栈的优点是事务、关系 JOIN、数据约束和权限关系都在一个系统里,基础设施数量少,团队可复用成熟的 SQL、备份、复制和监控体系。对于数据规模尚可、检索流量稳定、关系查询和事务一致性比极限 QPS 更重要的知识平台,这会是一个很有效的架构。
代价是检索型负载会和 OLTP 资源争用。向量索引体积大,过滤会影响 ANN 召回,批量更新与删除带来 Vacuum 和索引维护负担;要覆盖 Vault 的 Agent 并发画像,往往需要读写分离、分区、专用向量扩展和分片路由。组件数量看起来少了,数据库团队实际接手了搜索引擎的一部分职责。
判断:PostgreSQL 可以实现完整的 Vault 类系统,也能够通过量化、分区和分片承载很大的向量数据集;但对高并发 Agent 检索,它不是默认的省事方案。它更适合关系事务驱动、过滤关系复杂、团队具备 PostgreSQL 扩展和分片运维经验的场景。
4.3 OpenSearch:在线检索能力完整,运维负担也最大
OpenSearch 把 BM25、向量 ANN、Hybrid Search、过滤、聚合和排序作为一等能力。对于查询主要围绕来源、时间、国家、市场、概念和用户权限展开的 Vault,OpenSearch 的数据模型与在线检索路径更直接,也更容易按搜索负载扩展节点和副本。
架构设计
| 层次 | 组件与职责 | 设计要点 |
|---|---|---|
| 数据接入 | Connectors + Kafka / MSK / SQS | 来源同步、削峰、死信队列和事件回放 |
| 原始数据 | S3 | 保存原件、版本快照、批次清单和可重建索引的数据 |
| 文档处理 | Ingestion Workers / Data Prepper | 解析、去重、Chunk 切分、实体归一化和 Embedding |
| 在线索引 | OpenSearch | 每个 Chunk 一条文档,包含正文、向量、时间、来源、业务标签、tenant 和 ACL 字段 |
| 查询服务 | Search API + OpenSearch Query DSL | BM25、k-NN、Hybrid、共同过滤、RRF / normalization 和可选 reranker |
| 生命周期 | Index Template、Alias、ISM、Snapshot / Remote Store | 索引 generation、冷热策略、重建、归档和恢复 |
| 治理与评测 | 查询日志、ACL 更新事件、离线评测数据集 | 观测索引延迟、过滤召回、查询尾延迟和版本差异 |
连接器将原始材料和版本清单写入 S3,消息队列发送 DocumentChanged 事件。Worker 解析文档并创建 Chunk,计算 Embedding,批量写入 OpenSearch。建议以稳定的 chunk_id 作为文档 ID,并写入 document_id、document_version、source_id、published_at、country、market、concept、tenant_id、security_scope 和 acl_principals。原文和规范化快照留在 S3,OpenSearch 只承担可重建的查询投影。
Search API 根据用户身份生成强制过滤条件,再在同一个 Hybrid Search 请求中执行关键词与向量召回。共同的 tenant、时间、来源和安全域过滤应应用于各子查询,防止 BM25 和 ANN 面对不同候选空间。OpenSearch 的 search pipeline 可以对多路分数归一化,也支持 RRF 融合;对于研究问答,可以在候选集上叠加时间衰减、来源可信度和外部 reranker。OpenSearch Hybrid Search
向量引擎与容量规划
OpenSearch 支持多种 k-NN 引擎。Lucene HNSW、Faiss HNSW/IVF 和 JVector 对内存、查询性能、过滤和部署的取舍不同。Faiss 通常是大规模向量检索的重点候选;JVector 作为单独插件提供 DiskANN 风格的磁盘向量搜索,可以降低对全量向量常驻内存的依赖,但必须单独验证插件版本、升级路径和上层查询能力。OpenSearch Methods and Engines OpenSearch JVector
容量估算同样必须按 Chunk 数计算。对一亿个 768 维 float32 向量,原始向量数值约 307 GB。OpenSearch 文档给出的 HNSW 粗略估算公式为 1.1 × (4 × dimension + 8 × m) 字节/向量;在 dimension=768、m=16 时约 3.5 KB/向量,对一亿条记录约 352 GB 的索引量级。这个值是索引内存估算,不包括正文、元数据、Lucene 段、JVM Heap、OS 缓存和副本;副本会增加总向量数据量。实际常驻内存取决于引擎、量化、内存优化模式和缓存行为,必须用真实映射与并发压测确认。OpenSearch vector memory estimation
量化、IVF 和磁盘向量索引能改变成本曲线,但都需要评测召回损失、重排开销和冷缓存延迟。JVector 不能仅凭“DiskANN 风格”就假定会自然融入已有 Neural Search 或 Hybrid Search 流程;当前插件限制和 API 兼容性应按部署版本核实。对需要稳定 Hybrid Search 的平台,可以先用成熟引擎构建基线,再单独验证 JVector,而不是在上线第一天就同时迁移索引和查询管道。
高选择性过滤和权限
Vault 的问题往往包含明确时间范围、来源和市场条件。OpenSearch efficient k-NN filtering 能在搜索过程中应用过滤,Lucene、Faiss 和 JVector 在相应引擎及版本下均有支持。这样比先取全局 Top-K 再做 post-filter 更有机会返回足够的匹配结果。Hybrid Query 也能把共同过滤器应用到每个子查询。Efficient k-NN filtering
但“支持过滤”并不等于各种过滤组合都有相同召回和延迟。需要把时间窗、国家、市场、来源、租户和 ACL 作为组合条件测试,并专门覆盖高选择性过滤和极不均匀租户分布。若 ACL 只在召回后由应用层删除,结果数量和召回率都会受影响;权限条件应在查询执行前由服务端构造,并在索引更新延迟期间定义额外的授权校验策略。
OpenSearch Security 的 Document-Level Security(DLS)可以根据角色限制读取哪些文档,但官方文档明确说明 DLS 只限制读取,不限制写入;具有写权限的身份仍可能修改被隐藏的文档。因此 DLS 适合作为角色或安全域级纵深防御,不能取代写入身份隔离和 Search API 的租户过滤。细粒度 ACL 通常应由后端服务根据授权系统生成 Filter,并对权限撤销设置传播 SLO。OpenSearch Document-Level Security
更新一致性和索引恢复
OpenSearch 不是关系数据库。Bulk API 中的每个操作独立处理,批量请求可能部分成功,Worker 必须检查逐条结果并重试失败记录。事件应包含 document_id、version、operation 和 source checksum;对乱序事件使用外部版本或乐观并发控制,防止旧版本覆盖新版本。删除和 ACL 撤销要作为明确事件处理,不能靠定期全量同步碰运气。OpenSearch Bulk API
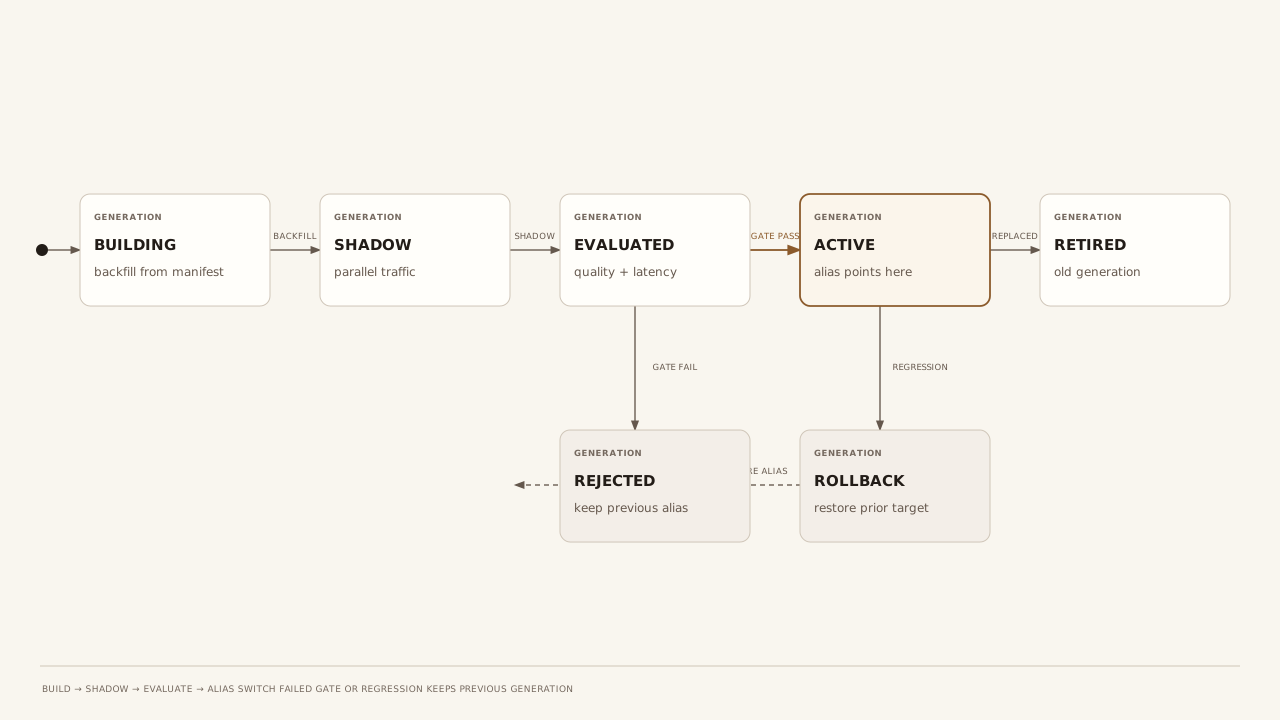
索引重建应使用新 generation:从 S3 清单读取确定版本,重放文档和变更事件,运行数据完整性与检索评测,再切换 Alias。这样可以保留旧索引作为回滚点。Index Template 统一字段映射、分析器和向量配置;生命周期策略负责 rollover、归档与删除。远端快照或 Remote Store 有助于恢复和降低部分本地持久化成本,但不能取消分片、节点、缓存和查询容量管理。
优缺点与适用判断
OpenSearch 的优势是检索能力集中、查询模型成熟,支持高并发在线搜索,能够按 Shard、副本和节点扩展。BM25、ANN、Hybrid、过滤和聚合都在同一个查询引擎内完成,适合 Agent 高频调用和复杂检索条件。其主要代价是集群运维、分片布局、向量索引内存/磁盘、段合并、升级兼容、索引重建和最终一致的权限传播。它不适合承担所有业务元数据事务,因此常见设计仍会保留轻量 PostgreSQL 控制面;但这不改变 OpenSearch 是在线检索主引擎的定位。
判断:三种方案中,OpenSearch 最贴合 Vault 的在线检索负载画像。它并不自动解决对象存储原生索引和计算存储完全解耦的问题,但在 BM25、ANN、Hybrid 和过滤检索上提供更直接的主栈能力。对这类系统,S3 保存事实数据、OpenSearch 保存可重建搜索投影,是较清晰的责任边界。
三种主栈的总体取舍
| 维度 | Snowflake 主栈 | PostgreSQL 主栈 | OpenSearch 主栈 |
|---|---|---|---|
| 主优势 | 数据治理、SQL 分析、托管 Hybrid Search | ACID、关系 JOIN、事务性 ACL | 在线 BM25、ANN、Hybrid 和查询扩展 |
| 亿级 Chunk | 受 Cortex Search 行数额度影响,需先确认上限 | 需量化、分区、读写隔离与分片规划 | 分片、量化及磁盘 ANN 更贴近搜索负载 |
| Agent 高并发 | 默认 QPS 是直接的准入风险 | 依赖读副本和分片,数据库资源会竞争 | 更符合搜索集群的水平扩展模型 |
| 过滤召回 | 托管实现,属性列和服务行为受产品约束 | SQL 过滤表达力强,ANN 候选受过滤影响 | 支持查询过程内高效 k-NN 过滤,仍需压测 |
| 权限 | owner’s rights 要求后端集中代理 | RLS 与关系 ACL 可在事务中组合 | API Filter + DLS 纵深防御 |
| 更新模型 | 源表与 Search Service 刷新之间存在延迟 | 业务状态和 Outbox 可事务提交 | 事件驱动的最终一致,需版本控制 |
| 运维 | 搜索集群负担较轻,配额和服务成本依赖 Snowflake | 组件少,但数据库团队承担搜索扩展复杂度 | 搜索集群运维最重,但检索控制力最高 |
| 适用条件 | 数据已在 Snowflake、检索 QPS 可协商满足 | 关系查询和事务是主导需求,团队擅长 PG 扩展 | 在线检索是核心,Agent QPS 和过滤召回优先 |
5. 不用 Embedding 时,三种数据库怎样做全文检索
“不用 Embedding”并不意味着三种平台提供相同的全文搜索能力。它们的索引结构、查询表达、相关性排序以及扩展方式差异很大。特别是 Snowflake Cortex Search 和 Snowflake SQL SEARCH 是两条不同的产品路径,不能把后者当成前者的 text-only 开关。
Snowflake:SQL SEARCH 可以纯文本检索,Cortex Search 则仍然要求向量索引
Snowflake 有两个容易混淆的能力。
SQL 层的 SEARCH 函数是纯文本路径。它接收 VARCHAR、VARIANT、OBJECT 和 ARRAY 等数据中的文本字段,先按 Analyzer 切分 Token,再根据 SEARCH_MODE 判断 OR、AND、PHRASE 或 EXACT 匹配。它返回是否匹配的布尔结果,不负责产生 BM25 相关性分数。为文本列启用 Search Optimization Service 的 FULL_TEXT access path 后,可以加速 SEARCH 谓词;配置时需要保证查询使用的 Analyzer 与索引定义一致。这个服务创建并维护用于跳过无关微分区的 search access path,后台维护需要额外存储和计算资源。SEARCH function FULL_TEXT search optimization
例如,投研库可以把标题、摘要和正文一起交给 SEARCH,指定 PHRASE 模式查找固定短语,也可以用 AND 要求多个关键词同时出现。对于证券代码、文件编号和来源 ID,仍应使用独立的结构化列与等值过滤。SEARCH 适合“哪些记录包含这些词”的检索任务;如果业务要按词频、稀有词权重和字段权重排序,它本身不提供 OpenSearch BM25 那样的相关性排序。最终可以按日期、来源等级或业务字段排序,也可以在 SQL 中自己构造权重,但那已经是应用定义的排名模型。
Cortex Search 是另一层托管检索服务。旧的单索引语法通过 ON 指定搜索列,并使用托管 Embedding 模型;未指定模型时使用默认模型。较新的多索引语法允许把字段分别定义为 TEXT INDEXES(关键词)和 VECTOR INDEXES(语义),同一列也可以同时进入两种索引。但官方 SQL 规定,多索引服务至少需要一个 VECTOR INDEX;只声明 TEXT INDEXES 会创建失败。因此,Cortex Search 的 Text Index 可以用于纯关键词查询,却不等于整个 Service 可以在完全没有向量索引的条件下工作。CREATE CORTEX SEARCH SERVICE
在工程取舍上,Snowflake SEARCH + FULL_TEXT Search Optimization 更像数据仓库中的加速文本谓词,和 SQL 查询、过滤、Join 一起使用;Cortex Search 则是托管检索产品,提供独立服务端点、托管 Embedding 和向量/文本索引能力。前者可以无 Embedding,但没有开箱即用的 BM25 排名和相同的检索 API;后者更接近一个应用层 Search Service,但不能当成纯文本索引服务使用。
PostgreSQL:原生 FTS 是关系数据库内的倒排索引,但排序信号比较有限
PostgreSQL 原生全文检索把文档转成 tsvector,把查询转成 tsquery。to_tsvector 根据文本搜索配置解析词语、去停用词并做词形归一化;GIN 索引保存词项到行的倒排关系;@@ 用于匹配。这样可以直接在 SQL 中把全文条件和 tenant、ACL、时间、来源等关系过滤 JOIN 到一起,整个查询仍在事务数据库内执行。
原生排序由 ts_rank 和 ts_rank_cd 提供。它们可以使用命中词频、词项位置、字段权重和文档长度归一化,但 PostgreSQL 官方明确说明,这两个排序函数不使用整个语料库的全局信息。它们不等同于 BM25 的全局词项稀有度计算。对于投资研究文档,这意味着常见词和稀有概念词之间的权重区分可能不如成熟 BM25 检索引擎自然;如果候选命中很多,GIN 负责找候选,后续仍要对匹配行计算排名。PostgreSQL Text Search Controls PostgreSQL Text Search Indexes
PostgreSQL 的一个优势是你可以把标题、关键词、摘要和正文分别设置 A/B/C/D 权重,再拼接成一个 tsvector;事务、RLS、关系 JOIN 和 FTS 可以在同一数据库中执行。短板是原生 FTS 的排名模型和高级搜索分析能力不如专用搜索引擎。需要真正 BM25 时,可以引入 Timescale 的 pg_textsearch 或 ParadeDB 的 pg_search 这样的扩展;前者提供 PostgreSQL 内的 BM25 排名索引,后者以 Tantivy/自定义索引把全文检索、BM25 和过滤能力放进 PostgreSQL。它们会把方案从“PostgreSQL 内置功能”变成“PostgreSQL + 特定扩展”,必须额外验证 PostgreSQL 版本兼容、索引维护、升级和分片支持。pg_textsearch ParadeDB pg_search中文及多语言检索还要认真选择 parser 和 dictionary,不能假定英文 Snowball 配置可以正确处理中文公司名、政策术语和中日韩资料。
OpenSearch:默认就是分布式 BM25 全文搜索,不需要任何 Dense Vector
OpenSearch 把全文检索作为基础能力。写入时,text 字段经 Analyzer 处理,产生 Token 和倒排索引;查询时,match 等 Full Text Query 使用相应 Analyzer 解析用户输入;默认 BM25 根据词频、逆文档频率和长度归一化计算相关性。这个过程不需要 Embedding 模型,也不需要在每份文档中保存 Dense Vector。
它的映射模型会明确区分 text 与 keyword。正文、标题、摘要使用 text,ticker、CUSIP、ISIN、报告 ID、来源 ID 等精确标识使用 keyword;日期、市场、国家、安全域和 ACL principal 则使用 date、numeric 或 keyword 等适当类型做过滤。一个字段如果既需要精确过滤又需要全文搜索,通常会用 multi-fields 分别维护 text 与 keyword 表示。Analyzer 可以在索引期和查询期控制大小写、标点、停用词、stemming、同义词与语言处理。查询 DSL 还支持 phrase、fuzzy、multi_match、字段 Boost 和 Highlight。OpenSearch Text field OpenSearch Keyword Search OpenSearch Match Query
因此,纯文本 OpenSearch 与 PostgreSQL 原生 FTS 的差别不只是前者有 BM25。OpenSearch 的分布式倒排索引、相关性排序、Analyzer 和搜索 DSL 是其核心数据模型;PostgreSQL 的 tsvector/Gin 则把全文索引嵌入关系表和 SQL 执行器,事务和关系操作更自然,但排序与大规模搜索管理需要额外设计。对于投研内容,OpenSearch 更容易给标题、摘要、正文、来源和主题字段设定不同权重,并对精确证券代码与自然语言文本采用不同查询方式。
用投研问题理解三条纯文本路径的差异
假设研究员搜索“NVDA 2025 年资本开支指引”,这类问题带有公司代码、年份和具体财务术语。OpenSearch 可以把 NVDA 作为 keyword 精确匹配,把正文和标题交给 BM25 排序;PostgreSQL 可以将代码过滤与 tsvector 查询组合,但原生 ts_rank 不会自动给予全库稀有词同样的 IDF 权重;Snowflake SEARCH 可以用 AND 或 PHRASE 判断这些词是否共同出现,再通过 SQL 过滤年份和来源,但 SEARCH 自身不会产生 BM25 相关性分数。
另一类问题是“哪些研究讨论了高利率环境下企业推迟长期资本投资”,而原始资料可能写成“higher-for-longer rates are delaying capex commitments”或“firms defer multi-year investment decisions”。纯文本索引只有在关键词重合、词形归一化、同义词扩展或查询改写能够覆盖时才会找到这些材料。OpenSearch 的同义词和 Query Rewrite 可以改善 lexical recall,PostgreSQL 也可以通过词典、同义词和业务扩展词表处理一部分差异;Snowflake SEARCH 可以做 Token/短语匹配,但没有自动语义理解。Dense Embedding 的价值恰恰在于处理这种表达不同但概念相近的情况。
| 维度 | Snowflake SQL SEARCH | PostgreSQL 原生 FTS | OpenSearch BM25 |
|---|---|---|---|
| 核心索引 | FULL_TEXT Search Optimization access path | tsvector + GIN/GiST | Analyzer + distributed inverted index |
| 查询语义 | Token、OR/AND、PHRASE、EXACT,返回匹配与否 | tsquery 匹配,返回 SQL 行 | match、phrase、multi_match、fuzzy 等全文查询 |
| 默认相关性排名 | SEARCH 不提供 BM25 score | ts_rank / ts_rank_cd,无全局语料统计 | BM25,默认相关性排序 |
| 语言处理 | Analyzer(DEFAULT / UNICODE / NO_OP) | 配置、Parser、Dictionary;可加语言扩展 | Analyzer、Tokenizer、Token Filter、Synonym |
| 精确标识符 | 结构化列等值过滤或 NO_OP | 独立列等值匹配 | keyword 字段 |
| 关系查询 | 与 Snowflake SQL、Join 和分析一起执行 | 与事务、JOIN、RLS 原生组合 | 由 Search API 和索引字段组织,跨业务关系通常回源 |
| 运维代价 | 仓库查询 + Search Optimization 的维护成本 | 数据库索引和事务负载共同承担 | 专用搜索集群、Shard、Replica、Segment 与生命周期 |
| Embedding | SEARCH 路径不需要;Cortex Search 需向量索引 | 原生 FTS 不需要 | BM25 不需要;只有 k-NN / Neural 路径需要 |
对于 Vault 这样的亿级投研库,如果要求完全不用 Embedding,OpenSearch 是三者中最直接的全文检索主栈;PostgreSQL 适合全文只是关系数据库查询的一部分、规模和并发有明确边界的环境;Snowflake 则适合搜索与仓库分析紧密结合、SQL 过滤已能满足排名要求的环境。若需要 Snowflake 的托管检索接口和语义召回,应选择 Cortex Search,并接受其向量索引要求;若只是查找关键词,使用 SEARCH + FULL_TEXT Search Optimization 更准确。
6. Embedding:覆盖范围、模型选择与成本
前面三种主栈的设计都提到了 Embedding,但它并不等于“搜索索引”。传统全文检索会把文本切词并建立倒排索引,BM25 根据查询词、词频和文档长度计算相关性;元数据过滤则依靠结构化字段索引。两者都不需要把文本转换成向量。
Embedding 解决的是另一类问题:把文本映射为高维数值向量,使表达不同、含义相近的内容能够通过向量距离匹配。只有系统启用 Dense Vector / ANN 语义检索时,文档侧才需要预先生成向量,查询侧也需要使用兼容的模型生成 Query Embedding。Hybrid Search 同时运行 BM25 和向量召回,因此才同时需要两套索引。
BM25 与向量检索是两条独立通道
Turbopuffer 的官方文档把 Full-Text Search 和 Vector Search 分成了两条独立能力。
它的 Full-Text Search Guide 用一个只有 id、content 的数据集演示 BM25。Schema 中只需要将文本字段设置为 full_text_search: true,然后按 content、BM25 和查询文本进行排序。示例没有 vector 字段,也没有调用 Embedding 模型。普通字符串过滤、时间和来源等属性过滤同样不依赖 Embedding。
Vector Search Guide 则使用 ANN 查询。向量可以由应用自己的模型生成后写入,也可以采用 Turbopuffer 的 Native Embeddings:在 schema 上为文本属性配置 embed 模型,Turbopuffer 在写入时生成文档向量,在查询时把查询文本转换为向量。Native Embeddings 只是代替应用自行调用 Embedding Provider 的托管方式,并不意味着向量检索可以不生成向量。
这两种能力可以组合,也可以分开使用。Turbopuffer 的 Hybrid Search 示例同时运行 ANN 与 BM25,再通过 RRF 合并结果;只有启用向量查询的那条分支需要 Embedding。也就是说,使用 Turbopuffer 不等于必须先把所有文本 Embedding 一遍。
有一个容易忽略的存储约束:Turbopuffer 文档说明,一个 Namespace 可以没有向量索引;一旦 Namespace 建立了向量索引,其中的文档就必须包含相应的向量属性。因此,如果业务明确只想给一部分资料生成向量,需要在 Namespace / 检索分区层面设计边界,或在实施前向厂商确认当前版本对缺失向量值的处理方式。不能简单假定同一个向量索引里可以任意混入大量没有向量字段的记录。Write documents
Native Embeddings 还会带来独立的成本和生命周期要求。Turbopuffer 按 Embedding Token 计费,并对模型调用实施速率限制;修改 schema 中的模型配置也不会自动重新计算历史向量,旧数据需要重新摄取。因而,模型升级、文档重分块和重新 Embedding 都应视为数据版本变更,而不是一次普通字段更新。Embedding documentation
Vault 的向量规模说明了什么
Bridgewater 与 Turbopuffer 在 2026 年 10 月的联合演讲,比此前介绍 Vault 的演讲披露了更多检索实现细节。Aaron Linsky 说明 Vault 收录约一亿份文档;Turbopuffer CTO Nikhil Benesch 随后解释向量索引、权限过滤和聚类搜索,并报告这批文档对应约四亿条向量记录,测量口径覆盖约 4.5 亿条向量,搜索 P90 约 120 毫秒。Can Your AI Analyst Keep a Secret? — 演讲与完整转录
这足以说明 Bridgewater 的生产检索路径大量依赖 Dense Vector。演讲还说明权限过滤索引与向量聚类协同工作:系统先判断用户有权限访问哪些向量簇,再在相关簇中进行近邻搜索。这一实现依赖向量空间及其聚类结构,不是单纯 BM25 能替代的能力。
四亿向量对应一亿文档,平均约为每份文档四条向量记录。比较合理的工程解释是系统对长文进行了分块或为不同文本单元生成了多条向量,但演讲没有公开具体的 chunking 规则、每类来源的向量覆盖率、模型配置,也没有明确说明是否存在不参与向量检索的文档类型。因此,不能把“平均四条向量/文档”写成每份文档固定切成四块,更不能据此断言 Vault 对所有原始材料都以相同方式生成 Embedding。
原因在于该案例值得借鉴,但不应直接复制它的向量规模。Bridgewater 的目标包括投资研究中的语义检索,以及在复杂文档级权限下保持高召回。它需要回答“市场参与者如何看待某种变化”这类不一定包含资料原文关键词的问题,语义向量能够帮助找出使用不同表述但讨论相同概念的研究材料。与此同时,演讲中反复出现的时间、来源、资产和访问权限条件仍由结构化过滤处理。Embedding 没有取代元数据索引,向量索引也没有取代 BM25。
三种主栈的向量检索路径
| 主栈 | 不使用 Embedding 的检索方式 | 启用语义向量时 |
|---|---|---|
| Snowflake | 可用 SEARCH 函数做 Token/短语匹配,并为列启用 FULL_TEXT Search Optimization;这条路径不生成向量 | Cortex Search 的单索引模式默认使用托管 Embedding;多索引模式虽然有独立 TEXT INDEX,但仍强制至少声明一个 VECTOR INDEX |
| PostgreSQL | 原生 Full Text Search(tsvector / GIN)和 BM25 扩展都不需要 Dense Embedding | pgvector 或 VectorChord 的 Dense ANN 列需要预先生成向量,查询文本也要生成同空间 Query Vector |
| OpenSearch | text 字段和 BM25 倒排索引不需要 Dense Embedding | k-NN / Neural Search 需要向量,可由 ingest pipeline 的模型生成,也可由外部 Worker 写入;Hybrid 同时执行 BM25 与向量分支 |
| Turbopuffer | full_text_search、BM25 和属性过滤不需要向量 | Namespace 启用向量索引后需要向量属性;可用 Native Embeddings 或自行生成并写入 |
Snowflake 的边界需要说得更准确:它确实有不依赖 Embedding 的纯文本路径,但这条路径不是 Cortex Search。SQL SEARCH 函数可以对 VARCHAR、VARIANT、OBJECT 和 ARRAY 中的文本做 Token 匹配,支持 OR、AND、PHRASE 和 EXACT 等模式;配合 Search Optimization Service 的 FULL_TEXT access path,可以加速符合条件的文本查询。它返回的是匹配判断,不提供 Cortex Search 那种托管检索服务和相关性排序,也不是 BM25。Cortex Search 的单索引 ON 模式使用托管向量 Embedding;多索引模式虽然允许 TEXT INDEX 做纯关键词查询,但创建服务仍要求至少一个 VECTOR INDEX。因此,Snowflake 的纯文本选择是 SQL SEARCH + FULL_TEXT Search Optimization,而不是只声明 TEXT INDEX 的 Cortex Search。
PostgreSQL 和 OpenSearch 则可以很自然地先部署纯文本检索。PostgreSQL 原生全文检索建立 tsvector 和 GIN 索引;OpenSearch 默认使用 BM25 对关键词查询评分。OpenSearch 官方的 Neural Search 教程把文本 Embedding 放在语义检索链路中单独介绍,也提供普通 match 关键词查询作为另一条路径。PostgreSQL Full Text Search OpenSearch Neural Search
向量覆盖范围应由查询需求决定
首先要区分原始文档、可检索文本和向量化单元。一个 PDF、研究报告或会议记录可能包含几十页内容。向量检索通常针对 Chunk,而不是把整份文件压缩成一个向量。Chunk 太大,向量只表达了混合主题;Chunk 太小,上下文被切碎,模型可能失去资产、日期、说话人和论证之间的关系。应把章节、段落、表格说明和时间戳作为切分线索,保留 document_id、chunk_id、页码或时间区间,以便检索结果可以回到原文。
对于一亿份文档,Embedding 成本取决于实际进入模型的 Token 总量,而不只是文档数。大量重复材料、短通知、低价值来源、过期快照和只用于审计留存的附件,未必值得生成 Dense Embedding。对相同正文的不同版本,可以在 checksum 或规范化文本层做去重;只对内容发生有效变化的 Chunk 重新生成向量。需要保留每条向量对应的模型名、模型版本、维度、分块版本和源文档版本,否则模型升级后无法判断索引中的向量是否处于同一个语义空间。
推荐先建立覆盖全库的文本与元数据索引,再把 Embedding 作为可扩展的语义检索层。一个较稳妥的起点是:所有通过质量门槛的文档都可用来源、时间、资产、国家、市场、概念和 ACL 字段过滤;有可提取正文的内容建立 BM25 索引;高价值的研究报告、内部研究记录和会议转录按 Chunk 生成 Dense Embedding。低价值、短期留存或只需要精确字段过滤的记录可以暂时不生成向量。查询时同时运行 BM25 全库检索和 Dense Vector 子集检索,使用 RRF 合并,并在需要时对候选集做 Rerank。结果中必须保留检索通道和覆盖范围,避免用户误以为语义检索覆盖了未向量化的全部资料。
这种分层方式有明确的召回边界:如果某份文档没有向量,它就不会成为 Dense ANN 分支的直接命中结果;它仍可能通过 BM25 和元数据过滤被找到。若业务要求“任何一份有权限的资料,都能通过自然语言语义相似度找到”,那么最终就需要对该搜索范围内所有可检索 Chunk 建立向量,而不是永久只 Embedding 一个精选子集。选择性向量化是成本与覆盖率的折中,必须通过真实查询评测量化遗漏。
用检索评测确定覆盖比例
不要先给所有数据做 Embedding,再期待模型自动带来更好的检索质量。先从真实投资研究问题中抽取评测集,标记目标文档、必须满足的时间/来源/资产条件,以及用户权限。对同一批问题分别测试 BM25、Dense ANN 和 Hybrid:BM25 更容易命中专有名词、证券代码、报告标题、精确短语和稀有术语;Dense 更擅长同义改写、概念描述和不使用原文词汇的自然语言提问;Hybrid 则尝试兼顾两者。
评估时既看 Precision@10、Recall@10 和 NDCG@10,也按查询类型分析失败原因。特别要记录“BM25 已经能找到、Embedding 没有改善”的问题,以及“只有向量召回才找到”的问题。若新增向量索引没有实质提升目标查询集的 Recall 或排名质量,就没有必要扩大覆盖范围;如果有明显语义召回缺口,再按来源类别、文档价值和查询热度扩大 Embedding 覆盖。模型、分块策略或覆盖比例发生变化,都应保留独立版本并执行回归测试。
对 Bridgewater 这类平台,我的建议不是把 Embedding 当成整个文档治理流水线的必经步骤,而是把它作为经过评测证明有价值的检索通道。BM25 和结构化过滤覆盖全库,Dense Vector 针对需要语义理解的文本单元扩展,权限与时间条件在两条检索路径中保持一致。若最终测试证明投资研究中的自然语言问题高度依赖语义召回,再把向量覆盖扩大到全部可检索 Chunk;在此之前,先做全量 Embedding 只会提前支付模型调用、向量存储和索引维护成本。
四亿条向量的 OpenAI Embedding 成本
Bridgewater / Turbopuffer 联合演讲中的约四亿条向量记录,可以作为估算规模,但不能直接用“四亿”乘一个固定单价。OpenAI Embeddings 按输入 Token 计费,不按向量条数计费;一条向量通常对应一个文本输入单元,真正影响价格的是该单元在分块后有多少 Token。
截至 2026 年 11 月,OpenAI 官方列出的文本 Embedding 模型价格为:text-embedding-3-small 每百万输入 Token 约 0.02 美元,text-embedding-3-large 每百万输入 Token 约 0.13 美元。Batch API 支持 /v1/embeddings,适合离线处理内容库;官方说明其价格比同步 API 低 50%,每个 Batch 通常在 24 小时内完成。OpenAI Embeddings models OpenAI Batch API
对四亿条输入记录,成本可以按以下公式估算:
每次完整向量化费用 = 400,000,000 × 平均每条输入 Token 数 ÷ 1,000,000 × 每百万 Token 价格。
“正常金融和投研文档”没有一个可信的统一平均长度。研究报告经常包含长段落、表格和多个主题,因此应当按最终送入 Embedding 模型的 Chunk 长度测算,而不能用文件字节数或页数直接替代 Token。下表把 256、512 和 1,024 Token 作为三个容量情景;它们是工程假设,不是 Bridgewater 已公开的 Chunk 大小。
| 每条向量输入平均 Token | 总输入 Token | 3-small 同步 | 3-small Batch | 3-large 同步 | 3-large Batch |
|---|---|---|---|---|---|
| 256 | 1,024 亿 | $2,048 | $1,024 | $13,312 | $6,656 |
| 512 | 2,048 亿 | $4,096 | $2,048 | $26,624 | $13,312 |
| 1,024 | 4,096 亿 | $8,192 | $4,096 | $53,248 | $26,624 |
因此,以每条 512 Token 作为中间估算,四亿条 Chunk 全部跑一遍 OpenAI Embedding,使用 3-small 的 Batch 大约是 2,048 美元,3-large 的 Batch 大约是 13,312 美元。单看一次性 Token 费用,这并不是不可承受的企业级成本。真正需要考虑的是文档解析、音视频转录、重复内容、增量更新、重分块后的重算,以及向量存储和 ANN 索引的长期成本。若文档有大量扫描件,OCR 的费用可能独立于 Embedding;如果把会议录音送入检索库,ASR 也不是 Embedding 价格的一部分。
模型维度会影响存储而非上述 Token 价格。OpenAI 当前默认输出维度为 3-small 的 1,536 维和 3-large 的 3,072 维,也允许使用 dimensions 参数缩短向量。若四亿条记录都以 float32 保存,原始向量数值约为 2.46 TB(3-small)或 4.92 TB(3-large),尚未包括 ANN 索引、元数据、正文、副本和缓存;采用 float16 或索引量化可以降低物理占用,但要用 Recall@K 验证精度变化。OpenAI Embeddings guide
还要把初次建库和线上查询分开预算。假设 Agent 全天候持续以 100 QPS 运行,平均每条查询 50 Token,按 30 天计算,每月 Query Embedding 约需 129.6 亿 Token;用 3-small 同步价格估算约 259 美元。若持续 1,000 QPS,则约为每月 1,296 亿 Token、约 2,592 美元。实际值应按真实查询 Token、每次 Agent 任务触发的向量查询次数和高峰持续时间计算;多路 Query Rewrite 会增加调用量,而只用 BM25 的查询不需要 Query Embedding。
这些数字假设每条向量记录只对一个 Chunk 计算一次 Embedding,并且该 Chunk 平均长度就是表中假设。它们不包括重试、模型版本迁移、重复文档重新计算和查询向量。真正上线前,应先抽样解析一批有代表性的研究报告、财报、邮件和会议转录,统计 Token 数的 P50/P90/P99,再把实际 Chunk 分布代入公式。不要使用“每篇文档平均两千 Token”这样的文件级假设来替代真实分块统计。
托管模型、自部署模型与统一 Embedding API
使用 OpenAI 本身没有技术问题。托管模型省去了 GPU 容量、模型发布、推理优化和运行维护,Batch API 对历史语料回填也很合适。以本文前面的 4 亿条、每条 512 Token 估算,text-embedding-3-small 的一次 Batch 输入成本约 2,048 美元;仅为节省这笔一次性费用而搭建 GPU 集群,通常不划算。
问题在于让 OpenAI 成为不可替换的系统边界。文档 Chunk、查询向量和索引如果直接依赖某个供应商的模型 ID、维度、输入指令和响应格式,模型更换就会变成一次全链路迁移。投研语料还有数据出域、第三方处理条款、供应商限额、批量回填排队和外部 API 可用性等要求。持续的 Query Embedding 费用虽然通常低于大规模索引存储,但 Agent 的多轮改写和高 QPS 会把调用量放大。
企业常见的工程形态不是所有团队都从零训练模型,也不是每个应用自己直接请求 OpenAI。实际落地可以提供统一的 Embedding API,在后面接托管模型或自部署模型。在线查询和历史回填应分开调度:在线池控制低延迟和突发并发,离线池使用大批次、动态批处理和可重放任务完成回填,避免数亿条历史任务挤占 Agent 的实时查询资源。
自部署时,可以用 Hugging Face Text Embeddings Inference(TEI)或 vLLM 提供模型服务。TEI 面向 Embedding 工作负载,提供 token-based dynamic batching、优化推理内核、Prometheus 指标和 OpenTelemetry tracing,并已列出 Qwen3 Embedding 的支持;vLLM 的 pooling 模型服务则提供 OpenAI-compatible /v1/embeddings 接口,适合已有统一 vLLM 推理平台的组织。TEI 文档 vLLM Pooling Models
**可自部署且公开评测达到或超过 text-embedding-3-large 的候选,首先看 Qwen3-Embedding。**Qwen 官方模型卡给出同一份 MTEB Multilingual 对比表(引用的排行榜快照为 2025-05-24):text-embedding-3-large 的 Mean(Task) 为 58.93、Retrieval 为 59.27;Qwen3-Embedding-4B 分别为 69.45、69.60;8B 分别为 70.58、70.88。两款 Qwen 模型支持 100 多种语言、32K 上下文和自定义输出维度。这个对比足以说明开源权重模型已经可以在通用多语言检索基准上达到更高分数,但不代表它在每一类金融语料和每种 Chunk 策略上都优于 OpenAI。Qwen3-Embedding 模型卡与评测表
| 模型 | 参数规模 | 默认/最大维度 | 公开评测结果 | 适合的定位 |
|---|---|---|---|---|
| text-embedding-3-large | 托管 API | 3,072 | MTEB Multilingual Mean(Task) 58.93 / Retrieval 59.27 | 托管服务基线,维护成本最低 |
| Qwen3-Embedding-4B | 4B | 2,560 | 同一表:69.45 / 69.60 | 自部署的首选对照组 |
| Qwen3-Embedding-8B | 8B | 4,096 | 同一表:70.58 / 70.88 | 更重的模型,验证质量提升是否值得 GPU 成本 |
| Harrier OSS v1 27B | 27B | 5,376;32,768 Token | MTEB v2 74.3 | 94 种语言;模型文件约 54.1 GB,适合高资源实验;新版基准不能与上面旧版多语言表直接排序 |
Microsoft 的 Harrier OSS v1 27B 是值得关注的高容量候选,模型卡标注 MIT License、94 种语言和 5,376 维输出;模型文件约 54.1 GB(BF16),还未计算运行时显存与并发余量。它的 MTEB v2 分数来自新版基准,不应与 Qwen 模型卡中 2025 年的 MTEB Multilingual 分数直接比较。可下载权重不等于自动满足企业许可要求,生产使用仍要核查模型卡和适用条款。Harrier OSS v1 模型卡 MTEB Leaderboard
如果希望先得到可操作的结果,我会用 Qwen3-Embedding-4B 与 text-embedding-3-large 对同一批金融文档做离线 A/B;只有当 4B 明显胜出或 8B 的收益足以覆盖 GPU 成本,才把向量生产切到自部署。若 GPU 平台已具备较高利用率,再评估 8B;Harrier 27B 更适合资源充足时作为质量上限实验,不建议直接作为第一个生产模型。模型卡公布的通用 MTEB 分数只是筛选线索,真正的验收指标应是目标语料上的 Recall@K、nDCG@10、过滤后的有效召回率和 p95 延迟。
这里还要保留一个检索工程上的边界:金融研究中的证券代码、ISIN/CUSIP、报告编号、日期、数值和专有缩写,通常不应只交给 Dense Embedding。即使使用高分模型,全文 BM25、结构化过滤和精确字段检索也应覆盖全库;Embedding 用来补足同义改写、概念表达和跨语言召回。需要进一步提升 Top-K 排名时,可以在候选集上增加专门的 Reranker,而不是把 Embedding 模型单独承担所有排序职责。
模型与索引必须版本化。至少记录 provider、model_id、固定模型 revision、维度、归一化策略、query/document 指令模板、Chunker 版本和输入 Token 统计。文档侧和查询侧要使用同一模型空间及匹配的指令约定;不同模型输出的向量不能直接混在同一 ANN 字段中比较。升级模型时应创建新的索引 generation,离线重算并与旧版本 shadow evaluation,达到质量和延迟门槛后再通过 alias 或路由切换。若要灰度双写,必须保留独立向量字段和模型版本,不能把两个语义空间拼成一个索引。
7. Turbopuffer 的上游文档处理:从原始资料到可检索记录
Bridgewater 的 Vault 收集来自 135 个外部来源的资料,也包括内部研究、写作、报告和会议录音。公开演讲确认了文档经过组织、索引和权限处理,但没有披露完整的解析器、OCR、ASR、Chunker、Embedding 模型和每个来源的 ETL 实现。因此,下面是依据公开演讲与 Turbopuffer API 还原出的工程流程,不应误认为是 Bridgewater 的内部原样架构。
Turbopuffer 接收的是带 ID 和属性字段的文档行。它的 API 能保存文本、元数据、权限字段和向量,建立 BM25、ANN 与过滤索引;Native Embeddings 可以在写入和查询时调用模型,把文本字段转换为向量。但它不是一个从外部网站、PDF、Word 和录音开始的通用内容理解平台。来源连接、授权核验、文件解析、OCR、ASR、规范化和 Chunk 切分仍应在上游的数据接入与处理系统完成。
可以把上游处理链路拆成以下阶段:
| 阶段 | 处理内容 | 应持久化的产物 |
|---|---|---|
| 1. Source Connectors | 对接数据供应商、内部知识库、邮件、文件库和会议系统;处理凭证、订阅、增量水位和许可范围 | source_id、原始 URI、来源版本、授权条款引用、同步水位 |
| 2. 原始材料归档 | 文件或录音先进入 S3 等对象存储,保留原始版本和 checksum | 原件、对象版本、checksum、采集时间和来源记录 |
| 3. 内容抽取 | PDF/HTML/Office 文档解析;必要时对扫描件 OCR;会议录音 ASR;提取表格、标题、作者和页码 | 规范化文本、表格文本、时间戳、解析版本和质量状态 |
| 4. 清洗与实体治理 | 去重、语言检测、编码修复、来源质量标记;识别国家、市场、公司、资产、概念和讨论时期 | document metadata、实体关系、ontology 标签、ACL 关系 |
| 5. Chunk 切分 | 按标题、章节、段落、表格和会议时间片切分;保留可追溯位置,避免跨主题拼接 | chunk_id、document_id、版本、页码/时间区间、正文 |
| 6. 检索特征生成 | 全文索引对文本切词;需要语义检索的 Chunk 生成 Embedding;结构化过滤字段独立保留 | BM25 文本、向量、模型版本、维度、过滤属性 |
| 7. Turbopuffer 写入 | 将每个 Chunk 作为带 ID 的 Row Upsert;启用 full_text_search、向量列和过滤属性索引 | 文档行、BM25 索引、ANN 索引和 Attribute Index |
| 8. 查询与证据回传 | 服务端解析用户权限,构造 ACL/时间/来源/市场过滤;运行 BM25、ANN 或 Hybrid;合并候选并取回原文证据 | 命中 Chunk、分数、检索通道、原文引用和查询 Trace |
| 9. 反馈与再摄取 | 研究员和 Agent 产生的新研究结论进入内容接入流程;修订原文或权限时按版本回放更新 | 新文档版本、增量事件、评测标签和审计记录 |
这个过程里最容易低估的是元数据和权限的价值。投资研究的查询通常不仅问“这段文字讲了什么”,还要限制材料的来源、发布时间、研究所讨论的市场时期、国家、资产以及当前用户的访问范围。文档本身和 Chunk 都需要保留稳定身份;权限可以继承自文档,也可以在少数场景下细化到 Chunk。Search API 根据用户和组生成过滤表达式,Turbopuffer 执行过滤与检索。Bridgewater 演讲明确说明,他们把用户、组和文档权限映射成查询过滤条件;过滤不是由 Embedding 自动理解或替代的。
Turbopuffer 自己负责的是数据持久化和检索索引。文本属性可以启用 BM25 full-text search;向量属性会进入其 ANN 索引;元数据属性使用 Attribute Index 支持过滤。官方文档描述其向量索引会自动构建,属性索引了解向量聚类结构,因此 Native Filtering 能先排除没有授权候选的簇,再在相关簇内查找近邻。它还管理对象存储、NVMe 和内存缓存。也就是说,复杂的向量索引和过滤执行在 Turbopuffer 内部,但把杂乱来源变成可检索的文档行,仍是客户的数据工程工作。Turbopuffer FTS Turbopuffer Vector Search Turbopuffer Write API
Embedding 的具体位置可以有两种实现。使用 Native Embeddings 时,写入指定文本属性及模型,Turbopuffer 在写入和查询时生成向量;应用不必自行调用模型 API,但需要承担其模型费率、Token 速率限制和重摄取要求。外部生成则由 Worker 调用 OpenAI Embeddings 或企业自部署模型,保存模型与分块版本后把向量和文本一起写进 Turbopuffer。外部方式更容易结合 OpenAI Batch API 做大规模初始回填,也更容易控制重试、限速和多模型评测。Native Embeddings 当前不支持输入后由模型自行切成可变数量向量的 contextual chunking 模式,因此文档切分不能交给它自动完成。Turbopuffer Native Embeddings
Turbopuffer 当前文档还列出 Native Embeddings 的组织级限速:新组织默认每分钟 1,024 个请求、每个模型 200 万 Token;厂商可以根据工作负载提高额度。按四亿条、每条 512 Token 计算,总量约 2,048 亿 Token;若完全按 200 万 Token/分钟处理,理论下限约 102,400 分钟,也就是 71 天。这个只是限速上限下的理想值,不包含解析、分批写入、重试、索引构建和其他客户流量。若要在较短窗口内回填大型历史语料,需要提前与 Turbopuffer 协商提升额度,或在外部 Worker 侧使用 OpenAI Batch API 等离线 Embedding 路径,再把向量批量写入。需要注意,OpenAI Batch API 的 50% 优惠适用于直接调用 OpenAI 的 Batch endpoint;不能假定 Turbopuffer Native Embeddings 会自动继承这项折扣。
对于只想给一部分文档生成向量的场景,还有一个需要落实到数据布局的细节:Turbopuffer Namespace 可以没有向量索引;一旦 Namespace 有向量索引,写入的文档就必须包含对应的向量属性。可行做法是把全库文本和元数据放在一个 BM25 Namespace,把精选的语义 Chunk 放在另一个带向量索引的 Namespace。查询时全库 BM25 和向量子集 ANN 并行检索,再按稳定 chunk_id 去重并用 RRF 融合。文档更新和 ACL 撤权必须同步投影到两个 Namespace,避免权限只在其中一个索引生效。Turbopuffer Write API
最后,不要把“四亿条向量”理解成 Turbopuffer 自动把一亿份原始 PDF 拆成四亿段并完成所有 Embedding。演讲只确认了文档数和向量记录规模;具体分块方式、哪些来源没有进入向量检索、如何处理表格与录音,公开信息不足。它能证明的是这套生产检索链路在大规模向量与复杂权限过滤下运行,而不是一个端到端无代码的文档理解流水线。
8. 写入一致性、过滤召回与多租户权限
8.1 跨存储写入的一致性
这套系统没有一个跨 S3、PostgreSQL 和 OpenSearch 的分布式事务。不能假设三边写入会同时成功。应当使用可重放的事件驱动流程,把文档版本作为一致性主线。
推荐采用以下规则:
- 每份文档有稳定 ID 和单调递增的 version。任何修改都产生新版本,不能只依赖更新时间判断先后。
- 原始对象先写入 S3,并记录对象版本、ETag 或 checksum。数据库事务再写文档状态和 Outbox 事件。
- Outbox Publisher 把事件发送到 Kafka、MSK 或其他持久消息系统。Worker 可以重复处理同一个事件,写入 OpenSearch 时必须幂等。
- OpenSearch 只接受不旧于当前版本的更新。删除通过 tombstone 或显式删除事件传播,不能把暂时未找到的文档理解为已删除。
- 索引完成后再推进 PostgreSQL 中的 indexed_version。读写路径可以据此判断是否达到 read-your-write 要求。
- 索引全量重建时创建新的索引 generation,验证数据和查询结果后再切换 alias。不要在生产索引上直接执行不可回滚的批量重建。
这样做的代价是最终一致,而不是跨系统强一致。对于 Agent 即时写入后马上检索的场景,可以提供写入确认水位:只有索引确认达到对应版本,API 才向调用方报告该版本可检索。若调用方选择异步写入,就需要接受短暂的索引延迟。
8.2 过滤条件与召回率
Vault 案例中的时间、来源、资产和国家条件不是可有可无的附加参数。它们会直接改变向量搜索应该访问的候选空间。过滤条件选择性越高,普通 ANN 搜索越容易出现两个极端:先搜索后过滤可能只剩少量结果;先过滤再精确计算则可能需要扫描很大的候选集。
OpenSearch 的 efficient k-NN filtering 已经比简单 post-filter 更完整。Lucene 会根据过滤后文档数量和 Top-K 决定采用精确预过滤或带过滤的近似搜索;Faiss 也有对应的过滤实现。OpenSearch 3.1 之后,部分 memory-optimized Faiss HNSW 场景还应用了 ACORN 优化。OpenSearch efficient k-NN filtering
但这与 Turbopuffer 的 Native Filtering 不是同一个机制。Turbopuffer 的属性索引知道向量索引的聚类结构,可以协助判断哪些向量簇需要探索;普通的过滤式 HNSW 仍然是在现有 ANN 图和过滤语义上做算法优化。两者都可能获得高召回,但索引之间的协同程度不同。
因此,OpenSearch 方案必须用真实查询分布验证过滤性能。不能只测没有过滤条件的 ANN Recall@10。至少要按过滤选择性、租户规模、时间范围和 ACL 条件分别测量。
8.3 多租户和权限模型
建议先采用共享索引加 tenant_id、namespace_id、ACL 标签和 routing key 的模式,避免每个租户都创建独立索引导致分片数量膨胀。对于数据量特别大的租户、严格的资源隔离要求或独立生命周期要求,再使用专属索引或专属集群。
检索 API 必须从认证上下文推导 tenant_id 和权限过滤条件,不能允许调用者任意覆盖。索引文档中的权限字段属于安全边界的一部分,权限变化需要有独立的更新和回收流程。对于权限撤销,系统需要定义可接受的传播时间,并通过最终 ACL 校验降低索引更新延迟期间的数据暴露风险。
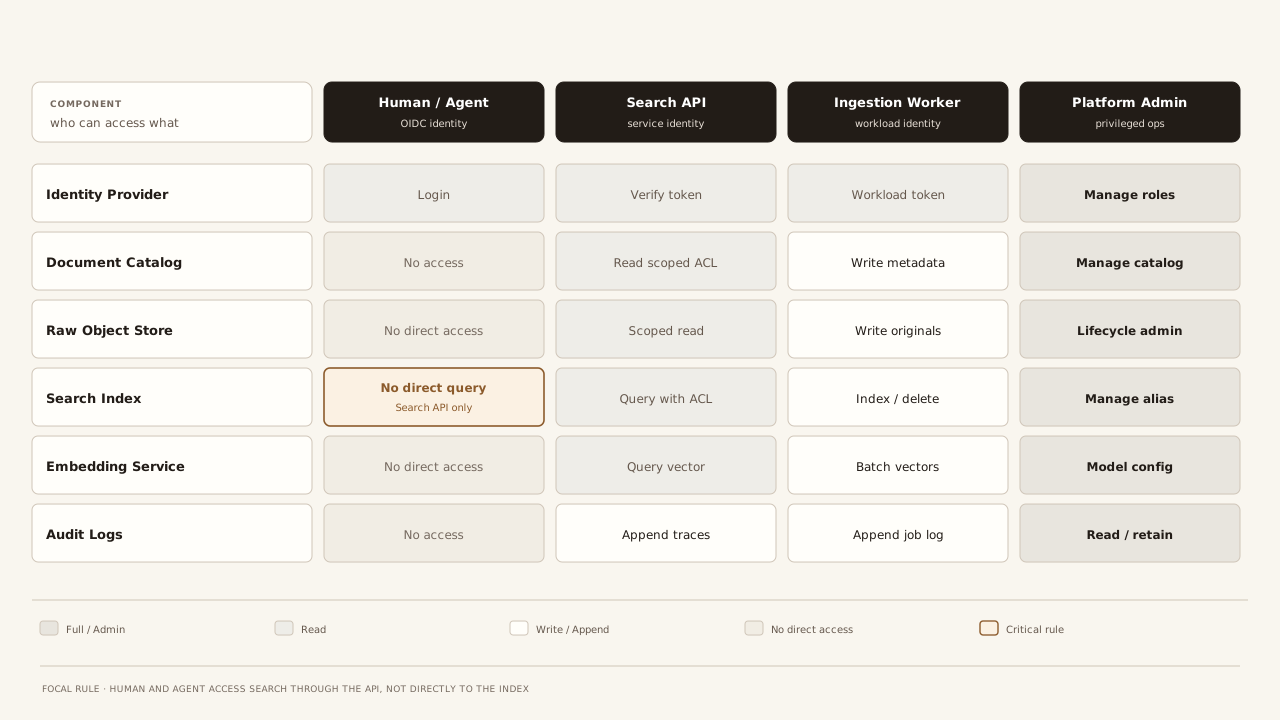
Namespace 与 OpenSearch index 不应一一对应。Namespace 是逻辑隔离和生命周期概念;Index、Shard 和 Routing 是物理布局决策。两者解耦后,才能根据文档数量、查询负载和租户增长重新分配数据。
9. 开放计算层:Iceberg、Spark 与 Trino
Snowflake 可以继续作为企业分析平台,但文档标准化数据最好保留开放格式,避免批处理和跨源查询被锁定在单一计算引擎中。这里讨论的是分析计算,不是在线检索路径。
9.1 用 Iceberg 建立开放数据路径
如果 Snowflake 已经是企业战略平台,不需要为了避免绑定而立即替换它;但也不应该让所有业务计算都只能在 Snowflake 内执行。更稳妥的做法是把数据格式、Catalog、业务计算逻辑和执行引擎分开:Snowflake 继续承担企业分析和现有数据产品,开放计算引擎则能直接读取同一份开放数据。
建议以 S3 + Parquet + Apache Iceberg 作为跨引擎的数据底座,使用独立 Iceberg REST Catalog 管理表元数据。Spark 作为第一种开放批处理引擎,负责大规模 ETL、文档派生数据处理、历史回填和批量特征计算。Snowflake 继续承担企业分析和适合其执行环境的 SQL 工作负载。不要把 Spark 当作在线查询服务,也不要把所有 SQL 都机械地迁移到 Spark。
Trino 则补上另一种能力:它是分布式、MPP SQL 查询引擎,重点是交互式查询和数据联邦,而不是替代 Spark 的批处理能力。它通过 Connector 访问不同数据源,每个 Connector 在 Trino 中配置成一个 Catalog。Trino 可以在同一条 SQL 中引用多个 Catalog,因此可以把 PostgreSQL、Snowflake 和 Iceberg 表放进同一查询中。官方文档列出了 PostgreSQL、Snowflake、Iceberg、Hive、Redshift、OpenSearch 等 Connector。Trino concepts
9.2 Trino 的 Connector 与跨源查询边界
| 数据源 | Trino 接入方式 | 适合的用途 |
|---|---|---|
| PostgreSQL | 官方 PostgreSQL Connector | 查询业务元数据、目录和关系数据;不应把高频 OLTP 流量绕到 Trino |
| Snowflake | 官方 Snowflake Connector | 查询已有企业数据集,与其他 Catalog 的数据组合 |
| S3 + Iceberg | Iceberg Connector + REST/Glue 等 Catalog | 直接查询开放数据湖,不经过 Snowflake |
| S3 + Hive/Parquet | Hive 或 Lakehouse Connector + AWS Glue/Hive Metastore | 查询已登记的外部表和数据湖文件 |
| AWS Glue Data Catalog | Iceberg、Hive 或 Lakehouse Connector 使用其元数据 | 发现和访问 Glue 管理的表;Glue 本身不是计算引擎 |
| Amazon Redshift | 官方 Redshift Connector | 查询 Redshift 数据仓库 |
| OpenSearch | 官方 OpenSearch Connector | 对索引做 SQL 型分析;不替代 OpenSearch 原生搜索 API |
因此,对问题“Trino 能不能用于 Snowflake、PostgreSQL 或 AWS 服务”,答案是可以,但要具体到数据源和 Connector。S3 并不是把任意文件路径直接变成 SQL 表:通常需要 Iceberg、Hive/Glue 等表元数据和受支持的文件格式。AWS Glue 是 Catalog 服务;Trino 使用 Glue 找到表和分区,再从 S3 读取数据。Redshift 有独立 Connector。当前 Trino 官方 Connector 清单没有 DynamoDB,也没有受维护的 Kinesis Connector;Kinesis Connector 已从 Trino 470 移除,不能把“支持 AWS”理解为支持所有 AWS 服务。Trino Lakehouse Connector Trino S3 support Trino Redshift Connector Trino ecosystem
例如,以下查询在语法上可以跨 Catalog 组合 Snowflake、PostgreSQL 和 Iceberg 数据:
SELECT
    d.document_id,
    d.source_type,
    a.market,
    p.owner
FROM snowflake.vault.analytics_documents d
JOIN postgres.catalog.document_acl p
    ON p.document_id = d.document_id
JOIN lakehouse.vault.document_attributes a
    ON a.document_id = d.document_id
WHERE d.created_at >= DATE '2026-01-01';
这里的 snowflake、postgres 和 lakehouse 是 Trino Catalog 名称示例。实际表名、Schema 和字段需要按各数据源配置调整。
需要特别注意跨源 Join 的执行位置。Trino 能把查询拆成多个 Stage,让 Worker 分别从不同数据源读取数据,再在 Trino 集群中完成 Join;但这不意味着 Snowflake、PostgreSQL 和 S3 之间自动实现了一个远端联合执行计划。Connector 可以把过滤、投影、聚合或 Join 下推到数据源,但下推能力因 Connector 和查询形态而异。官方文档指出,Join pushdown 通常要求参与 Join 的表属于同一个 Catalog;跨 Catalog Join 一般需要 Trino 拉取必要数据并在自身执行。Trino pushdown
所以,不要把 Trino 当作绕过 Snowflake 计算费用的万能代理。若查询主要扫描 Snowflake 的大表,直接在 Snowflake 执行可能更快、更便宜;若要把 Snowflake 大表与 PostgreSQL 小型 Catalog 做联接,应先检查 EXPLAIN、数据量、过滤下推和网络流量。也不要让 Trino 对 PostgreSQL 的业务主库执行无约束的大扫描,否则会把分析负载带到 OLTP 系统。
9.3 Spark 与 Trino 的分工
Spark 和 Trino 不是互相替代的产品。Spark 是通用分布式计算框架,适合长时间运行的批处理、ETL 和大规模转换;Trino 是面向 SQL 的分布式查询引擎,适合交互式分析和联邦查询。两者都可以访问 Iceberg,但执行模型和工作负载不同。
对 Vault,建议按以下顺序落地:
- 先把原始文档和派生资产放在 S3,结构化分析数据逐步采用 Parquet/Iceberg,并建立独立 Catalog。
- 先用 Snowflake 满足企业既有分析需求,同时验证 Spark 能否独立读取、转换和写回同一批 Iceberg 数据。这一步建立真正可运行的 Snowflake 替代路径。
- 当出现跨数据源 SQL、分析工具需要统一入口,或需要直接查询 Iceberg 而不进入 Snowflake 时,再部署 Trino。先从只读和受控查询开始,不把它作为所有应用的通用数据库代理。
- 业务服务继续通过自己的 API 访问 PostgreSQL Catalog、Search API 和受控计算任务,不直接把 Trino SQL 暴露给终端用户或 Agent。
Trino 本身也需要治理:独立的身份认证、Catalog 凭据、行列权限策略、查询审计、Resource Groups、并发和扫描量限制都不可缺少。Trino 的统一 SQL 入口不会自动统一底层数据源的权限语义;应明确最终由 Trino 代理身份访问,还是保留用户身份传递,并验证两种模式的审计与授权行为。
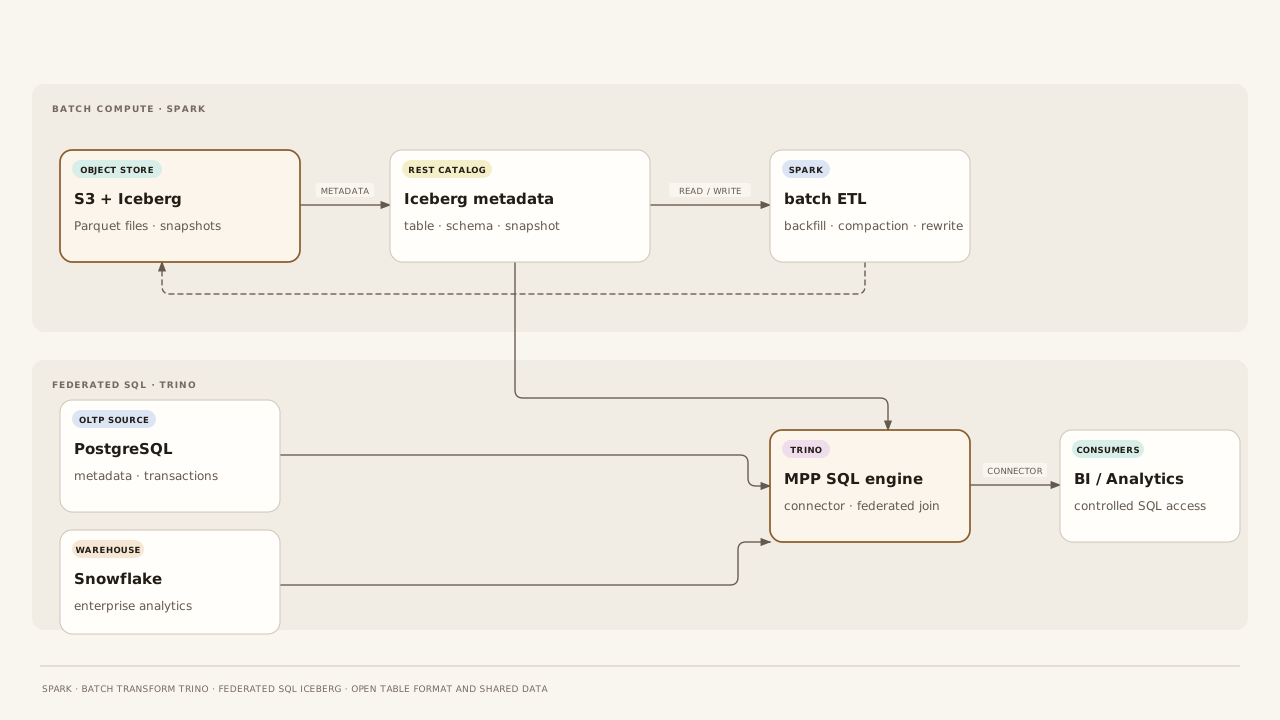
对当前阶段的结论是:Spark 应该先作为开放批处理引擎进入目标架构;Trino 应该作为可选的联邦 SQL 层,在真实跨源查询需求出现时部署。 最值得先做的不是同时建设 Spark 和 Trino 集群,而是用 Iceberg 建立一个 Snowflake 之外也能读取、写入和重算的数据路径。
10. 检索引擎的技术路线:磁盘向量、对象存储与列式执行
最近一轮检索基础设施的变化,重点已经不只是 HNSW 参数或 Embedding 模型,而是如何减少向量索引对内存的依赖、如何在对象存储上直接搜索,以及如何让全文、向量和结构化查询共享更高效的执行路径。
10.1 OpenSearch:JVector 把 DiskANN 带进搜索集群
OpenSearch 3.5 引入 JVector 插件。它使用纯 Java 实现 DiskANN 风格的近似最近邻搜索,向量索引从磁盘读取量化表示,再通过重排改善召回。官方文档还描述了并发插入、增量合并和量化码本逐步优化等能力。OpenSearch JVector plugin
这对向量数据量超过内存容量的场景很有吸引力。它把向量搜索的主要资源压力从常驻内存转向磁盘和缓存管理,降低了大向量集合部署的内存要求。
不过 JVector 目前有重要的集成限制:它是单独安装的插件,不能与原有的 opensearch-knn 插件共存;当前官方限制还指出,Neural Search 插件不识别 JVector engine,因此无法直接使用上游 Neural Search 的 neural 和 hybrid 查询路径。需要 Hybrid Search 的团队应先验证实际版本、查询管道和排序融合方式,不能只根据 DiskANN 能力就决定替换现有引擎。
10.2 OpenSearch Remote Store:远端持久化更完整,但还不是无状态搜索
Remote Store 让 translog、segment 和集群状态可以写入对象存储,Segment Replication 又让副本直接读取远端 segment。它改善了分片恢复和复制模型,也为降低本地副本存储开销创造条件。
这是一条渐进式路线:先把索引段可靠地放到远端,再优化缓存和恢复路径。它适合已经采用 OpenSearch、希望降低本地持久化成本的企业,但不应被描述为完整的计算存储分离。查询节点仍然需要运行 OpenSearch 并管理分片。
10.3 Lance 与 RemoteANN:对象存储原生向量检索开始有专门设计
Lance 的开源存储格式支持本地文件和多种对象存储,并把向量搜索、全文检索和 SQL 分析放在同一份列式数据集上。Lance
2026 年 10 月发布的论文《A Native Vector Search Engine for Cloud Object Storage》进一步研究了面向云对象存储共同设计索引与查询的 RemoteANN。它讨论的重点是如何降低对象存储访问延迟和请求开销,而不是简单地把为本地 SSD 设计的索引搬到 S3。RemoteANN paper
这条路线在存储模型上更接近 Turbopuffer。需要强调的是,论文结果属于研究评估,不能直接推导出某个部署规模下的生产 SLA;但它说明对象存储原生 ANN 已经成为一个有明确研究和实现方向的领域。
开源项目 Firn 则把 LanceDB 与 foyer 缓存结合,构建 RAM、NVMe 到 S3 的分层检索服务,提供多租户的向量、BM25 和 Hybrid Search。Firn repository 它是值得跟踪的 Turbopuffer 式开源实现,不过当前更适合作为 POC 和架构参考。上线前仍需要自行验证并发写入、删除语义、恢复、权限隔离、冷查询以及大规模数据下的缓存行为。
10.4 Quickwit:对象存储上的全文搜索已经有成熟架构实践
Quickwit 采用 Rust 实现,支持把索引放在 S3、Azure Blob 和 GCS 等云对象存储上,并让 Indexer 与 Searcher 独立扩缩。它的核心适用场景是日志、追踪、审计记录和其他以追加写入、不可变数据为主的内容。Quickwit architecture
它证明了在对象存储上做低成本全文搜索并不一定要自己写完整搜索引擎。对于日志和审计检索,Quickwit 值得与 OpenSearch 比较;但它的主要定位仍是全文搜索和可观测性,不应直接当成带有同等向量过滤语义的 Turbopuffer 替代品。
10.5 PostgreSQL 向量检索:pgvector 之外还有 VectorChord
如果希望把关系数据和向量检索放在同一个 PostgreSQL 查询里,可以继续关注 VectorChord。它在 PostgreSQL 内提供 IVF、RaBitQ 量化、磁盘友好索引和重排等能力;VectorChord-BM25 则提供 PostgreSQL 原生 BM25 检索扩展。VectorChord Hybrid Search documentation
这比简单地在 PostgreSQL 中加一个 pgvector 列更进一步,也适合需要 SQL JOIN、关系过滤和语义检索组合的系统。它仍然属于 PostgreSQL 的数据和计算模型,没有解决对象存储上的无状态搜索问题。若 OpenSearch 已经是主要检索引擎,再把所有向量复制到 VectorChord 通常只会增加写入和一致性成本。
10.6 Vespa:复杂过滤和排序值得单独评估
Vespa 把全文检索、向量搜索、过滤表达式和自定义排序模型放在同一个查询与排序体系中。它的 HNSW 搜索支持过滤,并提供 ACORN 等优化方向,也支持多个向量字段和多向量文档。Vespa approximate nearest-neighbor search
如果检索质量高度依赖复杂过滤、多个排序特征和业务相关性模型,Vespa 值得与 OpenSearch 进行真实数据对比。它不是以对象存储为持久事实来源的 Turbopuffer 式架构,因此重点是检索质量与排序能力,而非存储成本模型。
10.7 Turbopuffer v3:向量索引不再是存储主索引
Turbopuffer 自己也在改变架构。2026 年 9 月公开的 v3 设计说明计划把文档和索引布局转向列式存储,并把 ANN 从主索引变为普通的二级索引;10 月的开发日志进一步描述了端到端向量化查询执行,让批处理成为算子之间的默认数据交换方式。RIP, vector database The first search engine with fully vectorized query execution
这个方向值得重视。向量检索只是企业检索的一类查询,系统还要高效处理 BM25、过滤、聚合和结构化查询。如果所有文档都围绕向量主键布局,非向量查询可能承担额外的数据搬移和写放大。列式主存储与统一向量化执行能够让不同查询共享更通用的物理布局。
这些内容属于 Turbopuffer v3 的公开开发方向。其文章在 2026 年 10 月仍将正式投入生产描述为后续计划,不应当把开发日志中的设计目标当作当前所有生产环境已具备的能力。
11. 实施顺序与验收
实施顺序
第一阶段:建立检索质量基线
先用实际数据建立评测集。至少覆盖 BM25、纯向量、Hybrid、时间范围、来源、资产、国家、市场和 ACL 条件。除了 Precision@10,还应测 Recall@10、NDCG@10、过滤后结果数量和权限误放率。对每个问题保留人工标注的相关文档和应当排除的文档。
Bridgewater 的经验说明,评测集不需要一开始就很大,约两百条高质量样例就能发现明显问题。对企业内部系统,关键是持续从真实查询、用户反馈和失败案例中补充评测,而不是追求一次性准备一个庞大数据集。
第二阶段:搭建 OpenSearch 主检索链路
使用对象存储保存原文,PostgreSQL 保存控制面和 Outbox,OpenSearch 建立 BM25、ANN 和过滤索引。先使用成熟的 k-NN 引擎完成端到端流程,再评估 JVector 是否能降低向量内存开销。没有明确的测量结果前,不同时引入 pgvector 或 VectorChord 来维护第二套全量向量数据。
第三阶段:把 Snowflake 接入治理和反馈闭环
把来源元数据、文档版本、索引状态、Embedding 版本、查询日志和评测结果引入 Snowflake。通过分析找出低质量来源、时间过期材料、过滤选择性分布和热门查询。需要托管检索、且数据已经在 Snowflake 中的团队,可以单独建立 Cortex Search POC,与 OpenSearch 使用同一套评测集比较。
第四阶段:按成本瓶颈试验远端存储
当 OpenSearch 节点的本地磁盘和副本成本成为主要问题时,再测试 Remote Store、Segment Replication、磁盘向量索引、快照恢复和缓存预热。测试必须同时覆盖冷启动和热点负载。只看稳态热缓存下的延迟,容易低估对象存储请求量和重建时间。
如果仍无法达到目标成本,再用 LanceDB、Firn 或自建基于 Lance 的检索 POC 验证对象存储原生路线。此时应该用同样的评测集、文档版本和查询流量,与 OpenSearch 进行端到端比较,而不是只比较向量索引微基准。
验收指标
| 维度 | 必须验证的场景 | 指标 |
|---|---|---|
| 检索质量 | BM25、ANN、Hybrid | Precision@10、Recall@10、NDCG@10 |
| 过滤召回 | 无过滤、低/高选择性、多个 ACL 条件 | 过滤后 Recall@10、有效结果数 |
| 延迟 | 冷缓存、热缓存、并发 Agent | p50、p95、p99 |
| 写入 | 新增、更新、删除、重复事件 | 吞吐、可检索延迟、版本正确率 |
| 权限 | 权限授予、撤销、跨租户访问 | 权限传播时间、越权返回数 |
| 恢复 | 节点丢失、索引重建、对象存储恢复 | RTO、RPO、重建时间 |
| 经济性 | 本地 SSD、远端读、缓存 | 每百万文档成本、每百万查询成本、对象请求数 |
测试数据要保留真实的租户大小分布和元数据偏斜。例如,某些来源可能占多数文档,某些资产可能只对应少量记录;这些情况会影响过滤选择性和分片负载。评估时还应分别报告冷查询与热查询,避免平均值掩盖尾延迟。
12. 架构建议
对于 Vault 这类资料库,建议先落地 S3 + PostgreSQL Document Catalog + 异步处理 Worker + OpenSearch。原始文件、解析结果和 Chunk 保存在对象存储;Catalog 管理身份、版本、来源和 ACL;OpenSearch 承担 BM25、ANN、Hybrid 与在线过滤。Snowflake 继续负责企业分析和质量评估,Spark 提供开放批处理路径。只有出现稳定的跨源 SQL 需求时,再部署 Trino。
三种主栈的选择取决于主要工作负载。数据和治理已经集中在 Snowflake、检索 QPS 能满足产品限额时,可以优先评估 Cortex Search;关系事务、复杂 JOIN 和数据库内权限关系占主导时,PostgreSQL 更合适;如果高并发在线检索、BM25、向量召回和过滤是系统核心,OpenSearch 更直接。它的代价是独立集群的分片、索引和升级运维。
检索覆盖先从全文和结构化字段开始。Embedding 作为独立通道按查询评测逐步扩展,不必在入库时无差别处理所有 Chunk。四亿条记录、每条 512 Token 的估算中,OpenAI text-embedding-3-small Batch 一次性输入费用约 2,048 美元,3-large 约 13,312 美元;这笔费用本身不足以证明自建 GPU 服务更经济。建议先用 OpenAI 建立基线,再以 Qwen3-Embedding-4B 做同语料对照。统一 Embedding API、模型版本和索引 generation,才是避免供应商绑定的关键。
Turbopuffer 的核心也不在于某个 Embedding 模型。它把 Rust 查询引擎、对象存储持久化、WAL、SPFresh 向量聚类、BM25 倒排索引、属性过滤和分层缓存组合成一个专用系统。OpenSearch、PostgreSQL 与 S3 能覆盖大部分业务能力,但无法仅靠产品拼装获得相同的远端索引布局和查询执行效率。只有当本地索引成本、冷数据查询或节点扩缩已经成为可测量的瓶颈,再投入对象存储原生检索的 POC,才有明确的工程依据。
参考资料
Bridgewater 与 Turbopuffer
- Can Your AI Analyst Keep a Secret? — Bridgewater and Turbopuffer talk transcript
- Turbopuffer Write Documents
- Turbopuffer Native Embeddings
- Turbopuffer Hybrid Search
- Turbopuffer Vector Search Guide
- Turbopuffer Full-Text Search Guide
- Bridgewater:一亿份文档背后的 AI 投研系统
- Turbopuffer Architecture
- Turbopuffer Native Filtering
- Turbopuffer v3: RIP, vector database
- Turbopuffer: Fully vectorized query execution
- Turbopuffer v3 storage-engine development log
- Turbopuffer Concepts: SPFresh, Attribute Index, WAL and Cache Hierarchy
数据库与检索引擎
- ParadeDB pg_search
- Timescale pg_textsearch
- OpenSearch Match Query
- OpenSearch Keyword Search and BM25
- OpenSearch Text field type
- Snowflake Search Optimization Service
- Snowflake FULL_TEXT search optimization
- Snowflake SEARCH function
- OpenSearch Neural Search tutorial
- PostgreSQL Full Text Search
- Snowflake CREATE CORTEX SEARCH SERVICE
- Snowflake Cortex Search:Overview、known limitations 与 engine behavior
- Snowflake Cortex Search:Query API、filters 与 owner’s rights
- Snowflake Cortex Search:Costs
- PostgreSQL pgvector:Filtering、multitenancy and scaling
- PostgreSQL Row Security Policies
- PostgreSQL Table Partitioning
- VectorChord Hybrid Search
- OpenSearch Hybrid Search
- OpenSearch Efficient k-NN filtering
- OpenSearch Document-Level Security
- OpenSearch Methods and Engines
- OpenSearch JVector plugin
- OpenSearch Bulk API
- OpenSearch Remote-backed storage
- VectorChord
- Vespa: Approximate nearest-neighbor search
Embedding 模型与推理服务
- OpenAI Batch API guide
- OpenAI Embeddings guide
- OpenAI text-embedding-3-large model
- OpenAI text-embedding-3-small model
- OpenAI API Pricing
- Qwen3-Embedding 模型卡与 MTEB Multilingual 评测
- Microsoft Harrier OSS v1 27B 模型卡
- MTEB Leaderboard
- Hugging Face Text Embeddings Inference
- TEI Supported Models and Hardware
- vLLM Pooling Models and OpenAI-compatible Embeddings API
文档平台、数据湖与计算
- Autofile
- FormKiQ Core
- NemakiWare
- Pansoph
- RAGFlow
- Palantir Foundry Datasets
- Palantir Foundry Media Sets
- Palantir Ontology System
- Palantir Ontology Backend Architecture
- Lance format
- Firn
- Quickwit
- Trino concepts and architecture
- Trino Snowflake Connector
- Trino PostgreSQL Connector
- Trino Iceberg Connector
- Trino Lakehouse Connector
- Trino S3 file system support
- Trino query pushdown
- Trino connector ecosystem
研究资料
资料核对日期:2026-11-15。产品能力、配额和开发路线应以对应版本的官方资料为准;性能结论仍需在目标语料、硬件和查询分布下验证。