从零理解 Apache Spark 与 Snowpark:给开发者的分布式数据计算入门
如果你熟悉 Python、TypeScript、C++、SQL、数据库和常规后端系统,但没有使用过 Spark,那么第一次接触它时很容易产生几个疑问:Spark 是数据库吗?为什么 Python 代码能在几十台机器上执行?DataFrame 看起来像 pandas,为什么一次 show() 可能触发集群任务?Snowpark 又是什么,它和 Spark 是竞争关系,还是 Snowflake 版本的 Spark?
这些问题需要从执行模型开始理解。Spark 是一个分布式计算引擎,负责把数据处理任务拆分、调度到集群执行;Snowpark 是 Snowflake 提供的一组开发 API 和代码运行环境,让开发者使用 Python、Java 或 Scala 操作 Snowflake 中的数据。两者都能用 DataFrame 风格表达转换,但它们并不运行在同一种计算架构上。
本文以 Python 为主,不要求 Java 或 Scala 背景。示例尽量使用开发者熟悉的 SQL、函数调用和数据处理逻辑,再逐步展开分区、DAG、Shuffle、Catalyst、Executor、Warehouse 等概念。读完后,应该能够判断什么时候需要 Spark,什么时候直接使用 Snowpark,什么时候才值得研究 Snowpark Connect。
资料核对日期:2026 年 11 月 19 日。 Apache Spark 文档当前展示的版本为 4.3.0;Snowpark Connect 的兼容性文档目前说明支持 Apache Spark 3.5。产品支持范围可能变化,部署或迁移前应以目标环境的官方文档为准。
1. 先从熟悉的代码开始:Spark 到底解决什么问题?
假设有一份交易明细,包含数十亿行数据。我们要按交易日期、账户和币种汇总金额,并剔除无效交易。
用 SQL 表达非常自然:
SELECT trade_date, account_id, currency, SUM(amount) AS total_amount
FROM trades
WHERE status = 'VALID'
GROUP BY trade_date, account_id, currency;
如果数据只有几十万行,PostgreSQL、DuckDB 或 pandas 都可能轻松处理。数据增长到数十 TB,计算需要并行跨越多台机器,数据还分散在对象存储、数据湖或不同系统中时,单机程序就不再是合适的默认选择。
Spark 的工作是把这个逻辑变成分布式执行计划:读取数据时将数据切成多个 partition(分区),为每个分区生成任务,让多个 Executor 并行处理。需要按账户聚合时,同一账户的数据必须汇集到一起,Spark 会在网络和本地磁盘之间进行数据重分布,这一步通常称为 Shuffle。
Spark 不是某一种文件格式,也不是一个必须取代 PostgreSQL 的数据库。它是一个可以读取多种数据源、执行 SQL 和程序化转换、再把结果写回文件或数据库的计算引擎。常见数据源包括 Parquet、ORC、JSON、CSV、Hive 表、对象存储,以及通过 Connector 接入的数据库和消息系统。
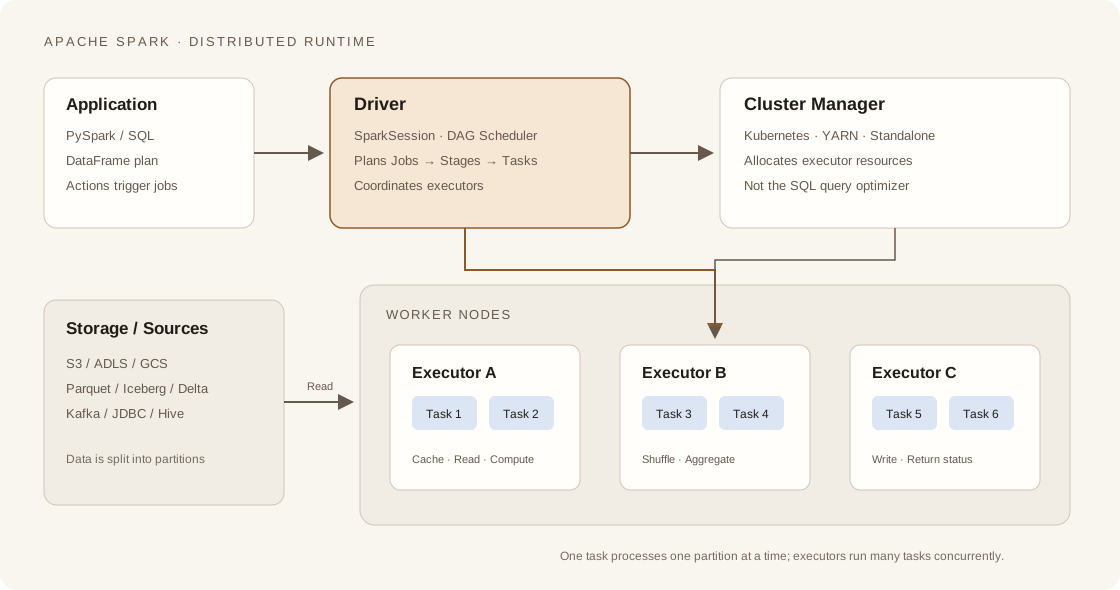
完整图示:HTML 查看 Spark 集群执行架构
Spark 与数据库、ETL 工具的关系
可以把 Spark 放在数据平台的计算层理解。数据库通常同时管理数据存储、索引/元数据、事务和查询执行;Spark 更关注如何在集群上执行一项计算。它可以读取数据库的数据,但通常不会接管源数据库的事务和数据权威。
传统 ETL 产品常把数据源、转换步骤、调度和运行环境封装成可配置流程。Spark 提供的是更底层、更通用的计算运行时:开发者可以用 SQL 或 Python 编写转换逻辑,再由 Airflow、Dagster、Databricks Workflows、Kubernetes CronJob 等外部调度器安排运行。Spark 本身也有 Structured Streaming 等持续处理能力,但它不等同于完整的数据治理或工作流平台。
一个常见的数据平台会把职责分开:对象存储保存原始文件,Iceberg/Delta Lake/Hive Metastore 等提供表和元数据语义,Spark 承担批处理或流处理,Catalog 管理表的发现和权限,调度器管理任务依赖与重试,BI 或应用消费处理结果。具体组合取决于组织希望自己运维多少基础设施。
2. 第一个核心概念:DataFrame,不必从 RDD 学起
如果你写过 pandas,Spark DataFrame 的外观会非常熟悉:
from pyspark.sql import functions as F

trades = spark.read.parquet("s3://lake/raw/trades/")

result = (
    trades
    .filter(F.col("status") == "VALID")
    .groupBy("trade_date", "account_id", "currency")
    .agg(F.sum("amount").alias("total_amount"))
)
这段代码描述了读取数据、过滤记录、分组和聚合。它没有要求你指定每个线程处理哪几行,也没有告诉 Spark 如何在机器之间传输数据。你表达的是“要什么”,Spark SQL 引擎负责分析和规划“怎么做”。
这里的 DataFrame 是带有列名和类型信息的分布式数据集合。它看起来像 pandas DataFrame,但执行语义完全不同。pandas 通常在当前 Python 进程中持有数据;Spark DataFrame 通常只是一个分布式计算计划的入口,数据实际保存在文件系统、对象存储或集群执行过程中产生的中间结果里。
这也解释了为什么 Spark DataFrame 不能随便当作 Python list 使用。你不能假设所有行都在当前进程内,也不能把一个几十 TB 的 DataFrame 转换成 Python 对象再操作。需要返回到 Driver 的数据应该是明确受控的小结果集。
RDD 是什么?为什么入门时可以先放一边
RDD(Resilient Distributed Dataset)是 Spark 较早期的底层抽象:一个分布在多个节点、可以并行操作并能在故障后重新计算的集合。它让开发者可以用 map、filter、flatMap 等函数定义任意转换。
例如:
rdd = spark.sparkContext.textFile("s3://lake/logs/")
errors = rdd.filter(lambda line: "ERROR" in line)
counts = errors.map(lambda line: (line.split()[0], 1)).reduceByKey(lambda a, b: a + b)
RDD 灵活,但引擎看到的通常是通用函数,难以理解函数内部到底访问了哪些列、是否可以下推过滤、是否可以裁剪不需要的字段。DataFrame 则保留了结构化信息,Spark SQL 可以据此做更完整的查询优化。官方文档也建议结构化数据处理优先使用 DataFrame,而不是低层 RDD API。
因此,现代 Spark 开发的主线是 Spark SQL + DataFrame。RDD 仍然有用,例如某些非结构化或需要精细控制的转换,但不应把它当成所有新项目的默认入口。
参考:Spark SQL、DataFrame 与 Dataset 指南 · PySpark 概览
3. 为什么代码还没执行?理解惰性计算与 Action
这是第一次使用 Spark 最容易踩到的认知差异。
df = spark.read.parquet("s3://lake/trades/")
valid = df.filter(F.col("status") == "VALID")
by_account = valid.groupBy("account_id").agg(F.sum("amount").alias("total"))
执行到这里,Spark 通常只是构建转换计划。它不会因为你调用了 filter() 就立刻把整份数据读入 Python,也不会每写一行就启动一个集群任务。这种行为叫 Lazy Evaluation(惰性计算)。
当你调用 Action,Spark 才需要真正得到结果:
by_account.show(20)
by_account.count()
by_account.write.mode("overwrite").parquet("s3://lake/curated/account_totals/")show()、count()、collect()、write 等操作会触发执行。一个 Action 会提交相应的执行工作;如果你连续执行 show() 和 write(),而中间没有缓存或持久化结果,Spark 可能重新计算上游计划。
这和普通函数调用的直觉不同。普通 Python 函数通常在调用时立即执行;Spark DataFrame API 更接近构建一个可优化的查询表达式。它和 ORM QuerySet、LINQ IQueryable、SQL AST 或编译器的中间表示有些相似:先描述操作,最后统一分析和执行。
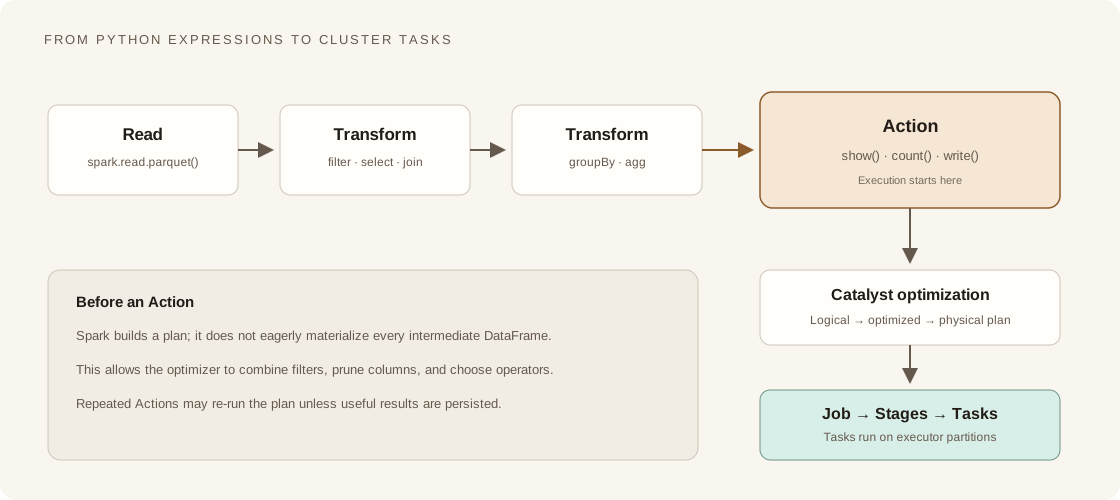
完整图示:HTML 查看惰性执行与任务生成
Transformation、Action 与缓存
Transformation 是构建新计划的操作,例如 select、filter、join、groupBy。Action 是要求执行并产生外部可见结果的操作,例如显示数据、返回计数、写文件或写表。
缓存并不是越多越好。若一个中间 DataFrame 被多个下游 Action 重复使用,cache() 或 persist() 可以避免重复计算;如果只用一次,缓存反而可能消耗 Executor 内存,并引入缓存管理开销。缓存也不是数据库事务或可靠的长期存储:Executor 丢失时,Spark 可以根据 lineage 重新计算丢失的分区。
enriched = (
    spark.read.parquet("s3://lake/raw/trades/")
    .filter(F.col("status") == "VALID")
    .join(accounts, "account_id")
    .select("trade_date", "account_id", "segment", "amount")
    .cache()
)

# 两个下游分支复用相同的中间结果
enriched.groupBy("segment").agg(F.sum("amount")).show()
enriched.write.mode("overwrite").parquet("s3://lake/curated/trades/")
看执行计划,而不是猜测代码快不快
explain() 可以显示 Spark 的逻辑计划和物理计划:
by_account.explain("formatted")刚入门时重点看三件事:过滤和列裁剪是否尽早发生;Join 使用了什么策略;聚合或 Join 是否引入 Shuffle。执行计划是判断引擎将如何处理数据的第一手信息,代码行数和链式 API 的长短并不能说明执行成本。
4. 集群如何真正跑起来:Driver、Executor、Task 和 Partition
Spark 应用通常有一个 Driver 进程和多个 Executor 进程。Driver 负责创建 SparkSession、构建并分析执行计划、协调 Job/Stage/Task 的调度,并收集少量最终结果。Executor 运行在工作节点上,负责执行任务、缓存分区数据、读写数据并向 Driver 汇报状态。
一个 Job 通常由某个 Action 触发。DAG Scheduler 会根据依赖关系把 Job 拆成 Stages;Stage 内再按分区生成 Tasks。Task 是实际分配给 Executor 执行的最小调度单元之一。假设某个 Stage 有 200 个输入分区,就可能产生约 200 个 Task;这些 Task 会在可用 Executor 的执行槽位上并行运行。
Partition 是逻辑数据切片,不等同于一台机器,也不等同于一个文件。一个 Executor 可以处理多个 Partition,一个 Partition 也可能在不同时间被不同 Executor 处理。增加分区通常能增加并行度,但分区太多会增加调度和小文件开销;分区太少则可能让集群资源闲置。
Shuffle:分布式计算真正昂贵的地方
过滤、选择列等操作通常可以在每个分区本地完成,不需要机器之间重新分配数据。按 key 聚合、按 key Join、全局排序等操作则经常需要 Shuffle:上游任务把数据按目标分区规则重新分组,写出中间数据,随后下游任务通过网络读取这些数据。
Shuffle 的代价不仅是网络流量,还包括序列化、磁盘 I/O、数据排序/哈希、内存压力和任务间同步。数据倾斜会让问题更严重:例如某个账户或某个状态值占据数据的 40%,按 key 分组时一个分区可能远大于其他分区,最终形成长尾 Task。集群平均 CPU 利用率看起来不高,作业却一直被少数慢任务拖住。
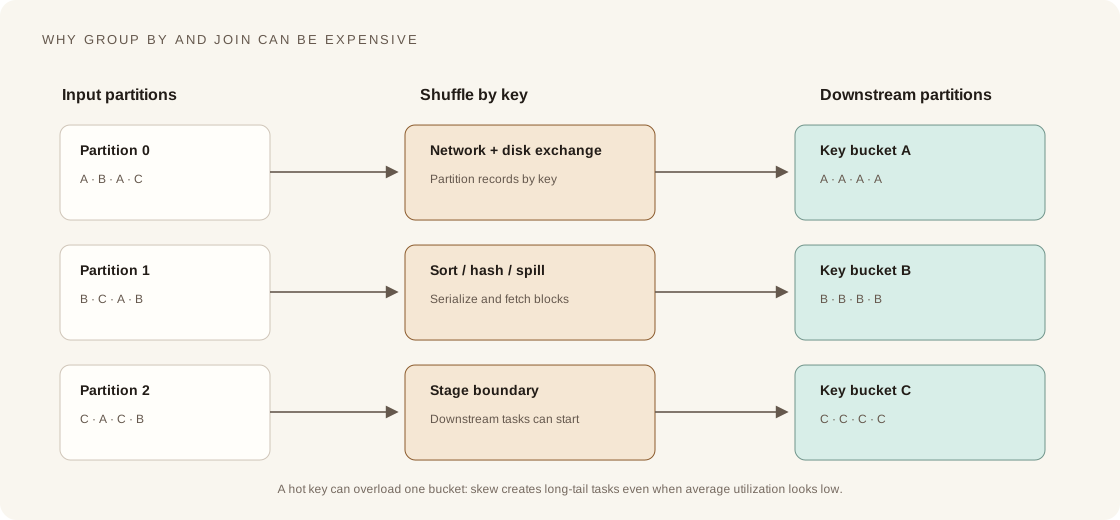
工程上应当关注 Spark UI 中的 Stage 时间、Shuffle Read/Write、Spill、Task Duration 分布、输入记录数和数据倾斜,而不是仅仅增加 Executor 数量。扩容无法修复不合理的 Join、倾斜 key 或大量小文件;它有时只会让更多资源等待同一个瓶颈。
5. Spark 为什么能优化 SQL:Catalyst、物理计划与 AQE
Spark SQL 不会简单地把 Python 的每个函数逐条解释执行。对于 DataFrame 的结构化操作,Spark 会形成逻辑计划,经过分析、规则优化和物理计划选择,再由执行引擎运行。
可以用编译器来类比:Python DataFrame API 是一种表达计算意图的前端;逻辑计划类似中间表示;Catalyst Optimizer 对表达式和关系操作做分析与重写;物理规划器选择 Join、Aggregate 等算子的执行方式;最后由 Spark 执行运行时在分区上执行任务。无论你使用 PySpark 还是 Spark SQL,结构化查询最终都进入同一个 Spark SQL 执行引擎。
Catalyst 能做的优化包括谓词下推(尽量提前过滤)、列裁剪(只读取需要的列)、常量折叠、表达式简化、Join 重排以及选择不同的物理算子。对于 Parquet 这样的列式格式,列裁剪意味着可以避免读取不需要的列;谓词下推和文件/分区元数据则可能进一步减少扫描的数据量。
Adaptive Query Execution(AQE)允许 Spark 在执行过程中根据运行时统计调整部分物理计划,例如合并过小的 Shuffle 分区、处理部分倾斜 Join、调整 Join 策略。它并不意味着任何计划都能自动变好:错误的统计信息、复杂 UDF、资源不足或数据布局问题仍可能让查询表现不佳。
PySpark 的 Python 代码到底在哪运行?
PySpark 的 DataFrame 操作大多是在 Python 侧构建表达式,Spark SQL 引擎负责执行结构化算子。不是每一行数据都要从 JVM 传到 Python,再由 Python 循环处理。对于 select、filter、groupBy 等内置函数,尽量让它们保持在 Spark SQL 可识别的表达式中,才能让优化器看到完整逻辑。
如果使用 Python UDF,执行过程可能需要在 JVM Executor 与 Python Worker 之间传递数据。数据序列化、进程间通信和 Python 函数调用会带来额外成本,也可能限制优化器对函数内部逻辑的理解。能用 pyspark.sql.functions 表达的转换,通常不应该改写成逐行 Python UDF。需要批量执行 Python 函数时,可以评估 Pandas UDF 和 Arrow,但它们仍有数据转换、批大小和内存方面的成本。
# 优先:SQL 引擎能识别表达式
clean = df.withColumn("net_amount", F.col("amount") - F.col("fee"))

# 谨慎:每行调用 Python 函数,可能跨 JVM/Python Worker 边界
from pyspark.sql.functions import udf
from pyspark.sql.types import StringType

@udf(StringType())
def normalize_status(value):
    return value.strip().upper() if value else None
这不是说 Python 不适合 Spark。PySpark 是正式支持的主流 API,支持 SQL、DataFrame、Structured Streaming 和 MLlib 等功能。关键是区分“用 Python 写计划”和“让 Python 逐行执行数据逻辑”。
6. Snowpark 是什么?它不是把 Spark 改个名字
Snowpark 是 Snowflake 提供的开发 API 和代码运行环境。Snowpark Python 允许开发者在 Python 中创建 DataFrame、调用 select/filter/join/groupBy 等操作,构建数据转换逻辑。其目标是让代码在 Snowflake 中处理数据,而不是把大批数据下载到本地 Python 进程再计算。
from snowflake.snowpark import Session
from snowflake.snowpark.functions import col, sum as sum_

session = Session.builder.configs(connection_parameters).create()

trades = session.table("RAW.TRADES")

result = (
    trades
    .filter(col("STATUS") == "VALID")
    .group_by("TRADE_DATE", "ACCOUNT_ID", "CURRENCY")
    .agg(sum_("AMOUNT").alias("TOTAL_AMOUNT"))
)

result.show()
代码表面上和 PySpark 很像,但背后的运行方式不同。Snowpark DataFrame 主要是 Snowflake SQL 的程序化构建接口:开发者通过 Python API 组合表达式,Snowpark 将可下推的转换转换为 SQL,由 Snowflake 的计算引擎在 Virtual Warehouse 上执行。数据通常留在 Snowflake 内部,不需要额外部署一套 Spark 集群。
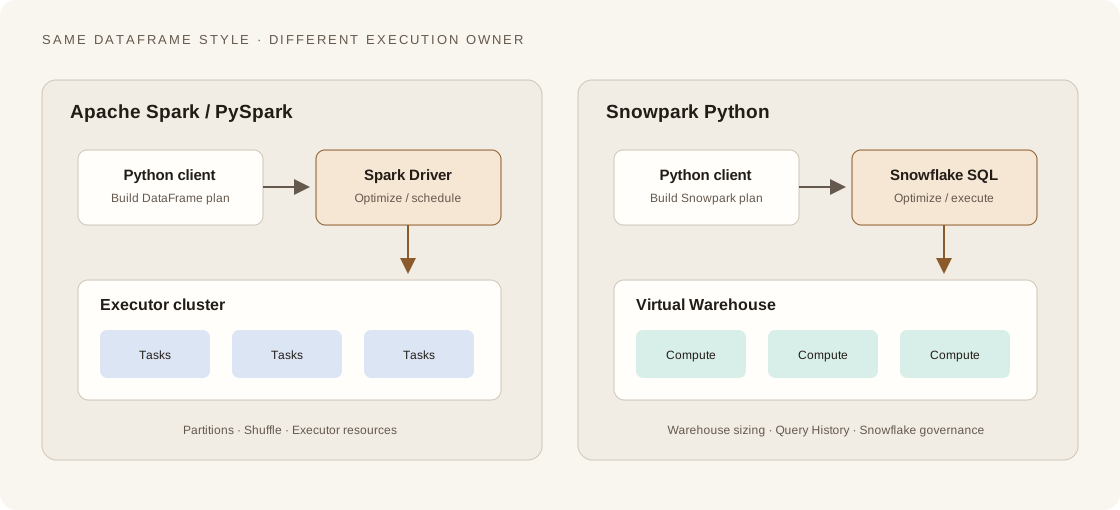
完整图示:HTML 查看 Spark 与 Snowpark 的执行边界
Snowpark Python 与 pandas 的差别
Snowpark DataFrame 也不是 pandas DataFrame。它通常是一个尚未执行的查询表达式,数据存储在 Snowflake 表或 Stage 中。调用 collect() 会把结果拉回 Python 客户端;如果结果很大,这可能造成客户端内存压力和网络成本。应优先使用 save_as_table()、write 或其他服务端操作,让结果继续留在 Snowflake。
# 在 Snowflake 内构建转换
df = session.table("RAW.TRADES").filter(col("STATUS") == "VALID")

# 把结果写回 Snowflake 表,计算仍由 Snowflake 执行
df.write.save_as_table("ANALYTICS.VALID_TRADES", mode="overwrite")

# 只在明确需要时把结果取回 Python
small_result = df.limit(100).collect()
Snowpark 的价值在于把 Python 的可组合性、IDE 类型提示和单元测试习惯带进数据工程,同时复用 Snowflake 的仓库计算、权限、审计和治理能力。它不是一个可以任意访问集群节点、控制每个分区和 Executor 的通用分布式计算框架。其优化边界是 Snowflake SQL 和 Snowflake 的运行环境。
官方文档:Snowpark API · Snowpark Python Developer Guide
7. Spark 与 Snowpark:相似的 DataFrame,不同的计算责任
开发者很容易只看 API:两边都有 filter、select、join、groupBy,代码也都能用 Python 写。但架构比较应该看数据在哪里、谁负责执行、谁负责扩展、哪些资源由谁运维。
| 比较维度 | Apache Spark / PySpark | Snowpark Python | Snowpark Connect for Spark |
|---|---|---|---|
| 产品性质 | 开源分布式计算引擎 | Snowflake 的开发 API | Spark Connect 兼容入口,后端由 Snowflake 执行 |
| 计算位置 | Spark Driver 与 Executor 集群 | Snowflake Virtual Warehouse | Warehouse 是常规执行路径;批作业可用 Code Bundles,Snowpark Submit 则使用 SPCS compute pool |
| 数据位置 | 对象存储、HDFS、Iceberg/Delta 等表格式、数据库和消息系统 | 主要是 Snowflake 表、Stage 及受支持的外部数据源 | Snowflake 表和受支持的外部数据源,具体受兼容性约束 |
| 执行抽象 | Partition、Task、Stage、Shuffle 和 DAG | Snowpark DataFrame 表达式转换为 SQL | Spark DataFrame 计划映射为 Snowflake SQL,不等于 Spark Task/Stage 执行 |
| 查询优化 | Catalyst、物理计划、AQE | Snowflake SQL 优化器 | Snowflake SQL 优化器 |
| API 与代码兼容性 | 原生 Spark API,包含 DataFrame、RDD 等接口 | 自己的 Snowpark API,方法风格相似但不等同于 PySpark | 支持一部分 Spark DataFrame API;不是完整 Spark API 兼容 |
| 自定义计算 | 可扩展 RDD、UDF、分布式 Python/JVM 逻辑及第三方组件 | 通过 UDF、UDTF、Stored Procedure 等机制扩展,执行环境受 Snowflake 约束 | 需落在已支持的 Spark Connect/DataFrame API 和 Snowflake UDF 等能力范围内 |
| 流处理与 ML | Structured Streaming、MLlib 等 Spark 生态能力 | 可结合 Snowpark ML 等 Snowflake 能力,但接口和运行模型不同 | 不等同于 Spark 全功能发行版;例如 Structured Streaming、RDD 和 pyspark.ml 不支持 |
| 资源管理 | 选择和运维集群或托管 Spark 服务 | Warehouse 尺寸、并发、自动暂停/恢复和资源策略 | Warehouse 管理计算;使用 Snowpark Submit 时还涉及 SPCS compute pool |
| 主要观测方式 | Spark UI、Event Log、Driver/Executor 日志 | Query History、Query Profile 和 Warehouse 使用情况 | Snowflake Query History、Query Profile 和 Query Tag |
| 典型用途 | 多源数据湖、复杂 ETL、流处理和分布式算法 | Snowflake 内的数据转换、数据产品和特征工程 | 将受支持的 PySpark DataFrame 工作负载迁移到 Snowflake 执行 |
理解这张表时,最应该关注的是执行责任。Spark DataFrame 描述的是一个分布式计算任务,Spark 引擎再把它拆成分区、Stage 和 Task,分发给 Executor;Snowpark DataFrame 描述的是一组关系型数据操作,Snowpark 把这些操作转换成 SQL,由 Snowflake 优化器决定扫描、Join、聚合和并行执行方式。两边都可能是惰性执行,也都提供链式 DataFrame API,但底层的计划、运行时和资源控制模型并不相同。
这也回答了“Snowpark 是不是用 Spark 的语法和思想写了一个 Snowflake 内部计算框架”这个问题:思想上有相似之处,语法风格也有重叠,但 Snowpark 不是 Spark 的 Snowflake 版本。 它借用了 DataFrame 这种声明式、可组合的编程体验,让开发者用 Python/Java/Scala 表达过滤、投影、Join 和聚合;Snowpark 自己负责把这些表达式编译成 Snowflake 能执行的查询。它没有在背后启动 Spark Driver、Executor,也不使用 Catalyst 来生成 Spark 物理执行计划。原生 Snowpark API 与 PySpark API 是两套接口,方法名称相似不代表代码可以直接互换。真正提供 Spark DataFrame 兼容入口的是下一节介绍的 Snowpark Connect for Spark。
Spark 的主要优势是计算环境和数据源的开放性。它可以在 Kubernetes、YARN 或 Standalone 集群运行,也有托管服务;你可以对分区、并行度、执行资源和数据读写路径做更多控制。代价是需要负责更多基础设施和作业运营。
Snowpark 的主要优势是计算靠近 Snowflake 中的数据。若数据本来就在 Snowflake,转换逻辑又主要是 SQL 能表达的关系操作,通常没有必要为了执行 DataFrame 风格的 Python 代码再部署 Spark 集群。代价是计算模型受 Snowflake 引擎、支持的 API 和运行环境约束,不能把 Spark 的集群控制能力直接带过来。
两者也不是简单的性能高低关系。对一份已经在 Snowflake 中的表做筛选、Join 和聚合,Snowpark 避免了把数据搬出平台再计算;如果任务需要读取多个对象存储位置、执行复杂分布式算法,或者必须运行依赖特定 Python 库的分布式代码,Spark 的适用范围通常更广。真实性能仍取决于数据位置、数据规模、计算形态、并发、仓库/集群配置和数据布局,不能仅凭产品名称判断。
8. Spark 能不能直接在 Snowflake 上运行?不一定要自建 Spark 集群
可以。Snowflake 现在提供 Snowpark Connect for Apache Spark,让现有 Spark Connect/PySpark 工作负载连接到 Snowflake,并由 Snowflake 计算引擎执行受支持的 DataFrame 操作。开发时可以使用 Snowflake Notebooks、VS Code 等工具;批处理可以通过 Snowflake 提供的提交机制运行。这里的关键不是把一套完整 Apache Spark 集群塞进 Warehouse,而是使用 Spark Connect 的客户端/服务端边界,把 Spark DataFrame 计划交给 Snowflake 端转换和执行。
需要区分三条路径,它们解决的问题不同。
| 路径 | 计算在哪里 | 是否需要自己运维 Spark 集群 | 适用情况 |
|---|---|---|---|
| 外部 Spark + Snowflake Connector | EMR、Databricks、Kubernetes 等外部 Spark 集群 | 需要管理或使用托管 Spark 集群 | Spark 是主要计算平台,只需要读写 Snowflake 数据 |
| Snowpark Connect for Spark | Snowflake Virtual Warehouse | 不需要外部 Spark 集群 | 希望复用受支持的 Spark DataFrame 代码,让 Snowflake 执行 SQL 型计算 |
| Snowpark Submit + Snowpark Container Services | Snowflake 管理的 SPCS compute pool/容器运行环境,并与 Warehouse 配合 | 不需要外部集群,但需要配置和管理 Snowflake compute pool | 需要 Snowpark Submit 的 cluster-mode 批作业运行方式或相关运行时能力 |
交互式和常规批处理:不需要 Bring Your Own Container
Snowpark Connect 使用 Spark Connect 协议,将客户端应用与服务端执行解耦。客户端不必持有 Spark Executor 集群;它提交 DataFrame 计划,Snowflake 端将支持的操作映射到 Snowflake SQL,由 Warehouse 执行。对于常规交互式开发,这意味着可以从本地 IDE 或 Snowflake Notebook 发起任务,不必先创建 EMR、Databricks 或自管 Spark 集群。
批处理也有 Warehouse 原生路径。当前 Snowflake 文档推荐使用 Code Bundles 提交 Spark 批作业:把 Python 脚本或打包后的 JAR 放到 Snowflake Stage,然后使用 EXECUTE CODE BUNDLE SQL,或者调用 REST API 提交任务。任务直接使用指定的 Warehouse 计算,不需要创建 Snowpark Container Services compute pool。SQL 提交是同步执行;REST API 可以异步提交并通过 job ID 查询状态,适合由 Airflow、CI/CD 或其他外部调度器编排。
一个精简的 Python 作业定义如下:
USE WAREHOUSE ETL_WH;
USE DATABASE ANALYTICS;
USE SCHEMA JOBS;

EXECUTE CODE BUNDLE
  FROM '@ANALYTICS.JOBS.APP_STAGE/spark_jobs'
  ENTRYPOINT = 'job.py'
  WITH SPECIFICATION $$
bundle:
  type: spark
  compute_type: warehouse
  language: python
  compute_options: {}
$$;
这里仍然是 Spark DataFrame 风格的 Python 应用,但运行位置是 Snowflake Warehouse。作业文件及其依赖从 Stage 提供;Warehouse 承担计算,作业状态和执行记录由 Snowflake 的 Code Bundle 执行历史等机制管理。实际部署还需要配置数据库、Schema、Stage、Warehouse 权限,以及 Python 依赖和外部访问集成。
什么时候会用到 Snowpark Container Services?
Snowpark Container Services(SPCS)是 Snowflake 管理的容器计算平台。它允许把应用及依赖打包成 OCI 镜像,在 Snowflake 的 compute pool 上运行。它适用于需要自定义操作系统依赖、运行时、第三方框架,或者需要持续运行服务、批处理作业和 GPU 计算的场景。
Spark 相关文档中仍保留 Snowpark Submit 这条批处理路径。它以 Python CLI 提交 Python 脚本或 Scala/Java JAR,使用 SPCS compute pool 承载 Spark driver,并与 Warehouse 配合执行工作负载。因此,这条路径确实会要求配置 compute pool;但它不是所有 Snowpark Connect 工作负载的前置条件。Snowflake 对新的批处理工作负载推荐优先评估 Code Bundles,因为 Code Bundles 直接运行在 Warehouse compute 上,不需要另建 SPCS compute pool。
“Bring your own container”描述的是 SPCS 的通用能力:开发者可以提交自己的 OCI 镜像和应用运行环境。如果目标只是把受支持的 PySpark DataFrame 作业放到 Snowflake 执行,不需要先制作 Spark 容器镜像。 优先看 Snowpark Connect 的 Warehouse 路径;如果选用 Snowpark Submit,则需要配置 SPCS compute pool,但用户提交的是 Python 脚本或 JAR,由 Snowpark Submit 负责部署作业运行环境,并不等于必须自行构建和维护 Spark Docker 镜像。只有在使用 SPCS 部署自定义服务或运行时,确实需要控制镜像内容时,才需要自己构建 OCI 镜像。
仍然可以把 Spark 留在 Snowflake 外面
如果组织已经把 Spark 作为统一计算平台,也可以继续运行外部 Spark 集群,并使用 Snowflake Connector for Spark 读写 Snowflake 表。Connector 支持双向数据传输,也可以把部分 Spark 逻辑下推到 Snowflake,但并非所有算子都能下推,例如 Spark UDF 就不能直接下推。此时 Spark 仍负责整体作业调度和可下推范围之外的计算,Snowflake 主要承担数据存储及部分 SQL 计算。
因此,“Spark 能否在 Snowflake 上运行”的答案是肯定的,但要先确定你说的是哪种形态:Spark Connector 是外部 Spark 访问 Snowflake;Snowpark Connect 是 Spark Connect 客户端连接 Snowflake 引擎;Code Bundles 是当前推荐的 Warehouse 批处理提交方式;Snowpark Submit 则利用 SPCS compute pool 提交 cluster-mode 作业。它们的资源模型、运维要求和兼容边界不同,不能都简称为“把 Spark 部署到 Snowflake”。
官方文档:Snowpark Connect for Apache Spark · Submit Spark jobs on Snowflake via Code Bundles · Using Snowpark Submit · Snowpark Container Services
9. 容易混淆的第三个名字:Snowpark Connect for Apache Spark
Snowpark Connect for Apache Spark 是 Spark Connect 协议实现:PySpark/Spark Connect 客户端提交 DataFrame 计划,Snowflake 端承接后把受支持的操作映射到 Snowflake SQL。常规执行路径不需要外部 Spark Executor 集群;若采用 Snowpark Submit,可以把 cluster-mode 作业运行在 SPCS compute pool,这条批处理部署路径另需配置 compute pool。Snowpark Connect 因而提供部分代码复用,但执行引擎仍不是 Apache Spark,兼容性和语义差异必须评估。
当前 Snowflake 文档列出的 Spark 版本支持范围是 Apache Spark 3.5;Spark 3.4 及更早版本、Spark 4.0 及更新版本不在该兼容范围内。不能因为本地 PySpark 已经升级到 4.x,就假设 Snowpark Connect 也能直接运行。
还有几个重要差异:
- Spark Classic 与 Spark Connect 的客户端边界不同。 Spark Connect 通过 gRPC 把客户端计划发送到服务端,部分错误会推迟到 Action 执行时才暴露。
- Snowflake 是底层执行引擎。 数据类型、SQL 翻译、文件 I/O、Catalog 元数据和部分 API 的行为与 Apache Spark 不完全相同。
- Spark 的分区控制不等于 Snowflake Warehouse 并行控制。
repartition()不会像 Spark 集群那样决定 Executor 并行度;某些写入路径中反而可能产生多个顺序执行的 COPY 操作。 - 缓存语义不同。 Snowflake 文档说明,Snowpark Connect 的缓存会物化为临时表,并不等同于 Spark Executor 的纯内存缓存;重复 Action 也可能重复执行查询计划。
- 可观测性需要换工具。
explain()看到的是 Snowflake 执行计划,不是 Spark 的物理计划;应结合 Snowflake Query History 和 Query Tag 关联作业。
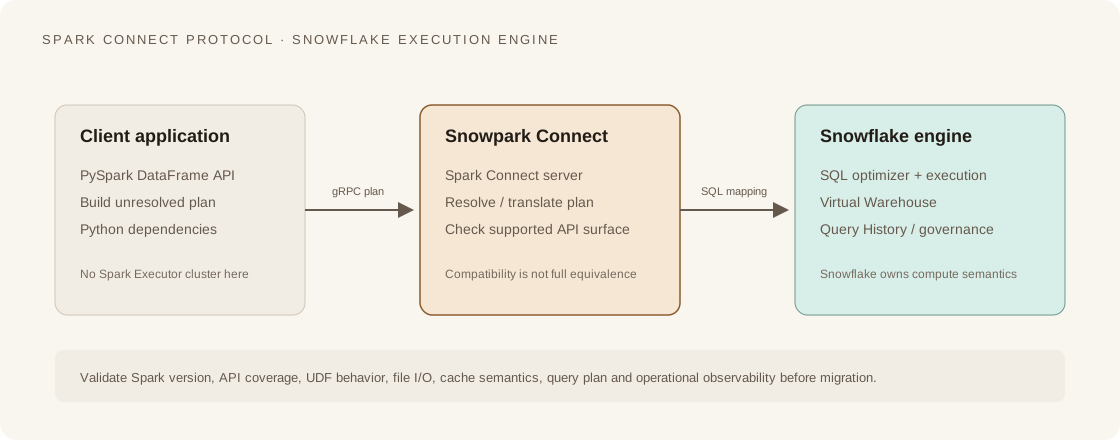
完整图示:HTML 查看 Snowpark Connect 执行边界
这意味着 Snowpark Connect 的迁移策略应该是“逐项验证可复用的 PySpark 逻辑”,而不是“把 Spark 作业地址改一下”。先确认 API 覆盖、数据源和文件路径、UDF、临时视图、缓存、事务语义和监控方式,再用真实数据做结果一致性与成本性能对比。
官方资料:Snowpark Connect for Spark · 与 Apache Spark 的已知差异和限制 · DataFrame API 兼容性
10. 另一个经常被误认为 Snowpark 的组件:Snowflake Connector for Spark
Snowflake Connector for Spark 与 Snowpark Connect 是不同的集成方式。
Snowflake Connector for Spark 的典型用途,是让外部 Spark 作业读取或写入 Snowflake 数据。Spark 仍然是计算引擎,Spark 集群仍然承担整体作业调度和主要计算;Connector 负责在 Spark 与 Snowflake 之间传输数据,并尝试把可转换的部分操作下推给 Snowflake。下推并不覆盖所有算子,例如 Spark UDF 不能直接下推。它适合组织已经运营外部 Spark 平台、又需要访问 Snowflake 表的场景。
Snowpark 则把开发 API 和计算放在 Snowflake 侧。Snowpark Connect 又进一步提供 Spark Connect 兼容客户端,让一部分 PySpark DataFrame 工作负载在 Snowflake 执行。三者的边界可以概括为:
| 组件 | 谁执行计算 | 谁持有主要数据 | 常见用途 |
|---|---|---|---|
| Spark + Snowflake Connector | 外部 Spark 集群 | Spark 可访问的数据源与 Snowflake 表 | Spark 作业读写 Snowflake |
| Snowpark Python | Snowflake 引擎 | Snowflake | 在 Snowflake 内用 Python API 构建数据转换 |
| Snowpark Connect for Spark | Snowflake 引擎 | Snowflake | 复用受支持的 PySpark/Spark Connect 代码 |
不要把 Connector 的“Spark 可以访问 Snowflake”误读成“Snowflake 提供了 Spark 计算集群”。这会直接影响架构、网络、成本和运维责任。
官方文档:Snowflake Connector for Spark
11. 在 Snowflake 内部,什么时候需要 Snowpark,什么时候应该用原生功能?
架构选型不应一开始就在 Snowpark 和 Spark 之间二选一。Snowflake 本身已经提供 SQL 计算、增量数据管道、任务编排、数据摄取、UDF 和容器运行时。对大多数只在 Snowflake 内部处理数据的场景,应先判断这些原生能力是否已经满足需求。
先判断是否真的需要 Python API
如果需求可以用 SQL 清楚表达,例如字段清洗、过滤、Join、聚合、窗口计算和表之间的数据转换,先用 Snowflake SQL。SQL 是这里最直接的接口,也便于查询优化器理解执行逻辑。引入 Python 不会自动提高性能或可维护性。
Snowpark Python 适合希望把业务转换逻辑组织成可测试、可复用的 Python 代码,同时让数据继续留在 Snowflake 的情况。例如,团队已有一套 Python 数据处理函数,需要在 Snowflake 表上组合 DataFrame 转换;需要写 Python UDF/UDTF 扩展 SQL 表达能力;或者需要把 Python 逻辑封装成 Stored Procedure,交给 Snowflake Task 或其他调用方执行。Snowpark 会把结构化 DataFrame 操作交给 Snowflake 引擎,UDF 和 Stored Procedure 也可以在服务端执行,从而避免将大批明细数据拉回客户端。
Snowpark 并不意味着任意 Python 程序都能自然地在 Warehouse 中运行。第三方包、运行时、网络访问和资源都受到 Snowflake 托管执行环境的约束。能用 SQL 函数完成的转换,不必包一层 Python UDF;需要长期运行的服务、自定义 OS 依赖、特殊运行时或 GPU 时,应评估 Snowpark Container Services,而不是强行把代码塞进普通 Snowpark Python UDF。
机器学习工作流则应单独看 Snowflake ML。它不只是 Snowpark Python 再加几种 ML 库,而是一套覆盖特征工程、训练、实验、模型注册、推理、观测和血缘的能力组合。训练运行在 Snowflake Container Runtime,支持分布式特征处理和 CPU/GPU 训练;Feature Store 管理特征数据;ML Jobs 编排训练任务;Model Registry 管理模型版本并提供推理入口。需要 GPU 模型服务时,Model Serving 可以把模型部署到 Snowpark Container Services。这里有两个容易混淆的运行时:Container Runtime 是 Snowflake ML 提供的预构建训练环境,Snowpark Container Services 则是运行自定义 OCI 容器、服务和 Job 的平台。若项目需要的是完整 ML lifecycle,应先评估 Snowflake ML;只有需要自行控制容器应用、运行时或服务拓扑时,再直接使用 SPCS。参考:Snowflake ML 概览。
参考:Snowpark Python Developer Guide · Python UDF · Python Stored Procedures
很多数据管道不需要 Snowpark:Dynamic Tables、Streams & Tasks 和 Materialized Views
如果目标只是把几张 Snowflake 表持续转换成新的分析表,Dynamic Tables 往往比自己编写 Snowpark 作业和调度更简单。开发者声明一个 SELECT 和目标数据新鲜度(TARGET_LAG),Snowflake 负责依赖关系、刷新时机以及支持范围内的增量计算。它适合多表 Join、聚合、窗口计算和分层数据管道。业务逻辑本身是声明式 SQL 时,不需要先写 Python 程序来管理刷新过程。
当管道需要过程控制时,选择就会变化。Streams 用来跟踪表的变更,Tasks 负责按计划或依赖关系运行 SQL、Stored Procedure 等逻辑。它们更适合需要 MERGE/复杂 upsert、分支判断、外部函数调用、定制重试、CRON 时间表或调用 Snowpark Stored Procedure 的场景。Dynamic Tables 与 Streams & Tasks 可以在一条管道里混合使用,不必强制所有步骤都采用同一种机制。
Materialized View 是另一种问题:它主要用于加速对单张基础表的重复查询,优化器可以透明地使用物化结果。它不是用来构建多阶段 ETL 的通用替代方案。
| 需求 | 优先考虑 | 原因与边界 |
|---|---|---|
| 多表 SQL 转换、Join、聚合、分层数据管道 | Dynamic Tables | 声明 SELECT 和目标新鲜度,由 Snowflake 管理刷新;适合声明式数据流程 |
| MERGE、复杂 upsert、过程逻辑、外部调用、定制重试或调度 | Streams & Tasks | 可以组合 SQL、Stored Procedure、Snowpark 逻辑,控制每一步如何执行 |
| 单表上的重复查询需要加速 | Materialized Views | 侧重查询加速,而不是构建数据管道 |
| 自定义 Python 转换、UDF/UDTF 或可复用 Python 管道 | Snowpark Python | 适合数据留在 Snowflake、逻辑适合 Snowflake 运行时的情况 |
| 自定义容器、特殊系统依赖、GPU、长时间运行的服务或批处理 | Snowpark Container Services | 提供独立的容器运行环境和 compute pool,代价是需要管理镜像、资源池和服务生命周期 |
有一个容易被忽略的限制:Dynamic Tables 不是能执行任意 Snowpark 代码的调度器。官方决策指南明确将 Snowpark 标为不支持的 Dynamic Table 管道表达方式;部分 SQL UDF/UDTF 则在指定条件下支持。需要运行 Snowpark 程序时,通常应通过 Streams & Tasks 调用 Stored Procedure,或采用其他适合的编排方式。Dynamic Tables 的输出表也是只读的,不能直接对其执行 INSERT、UPDATE、DELETE 或 TRUNCATE。
参考:Dynamic Tables 决策指南 · Dynamic Tables 概览
数据摄取也有原生路径,不要让 Spark 代替 Loader
数据进入 Snowflake 的方式与后续如何计算是两个独立决策。已经落在 S3、Azure Blob 或 GCS 的批量文件,通常用 COPY INTO 装载;文件持续到达、希望自动连续装载时,用 Snowpipe;生产者直接发送行数据、需要更低摄取延迟且不想先生成文件时,评估 Snowpipe Streaming。简单的列重排、列过滤和类型转换可以在 COPY 装载过程中完成,无需先启动 Spark 清洗一遍。
如果摄取阶段涉及复杂跨源关联、状态处理、事件时间窗口或必须运行的专用 Python/JVM 库,那是另一类计算任务,可以在外部用 Spark 或流处理平台完成,再将结果写入 Snowflake。关键是不要把文件摄取、转换和调度三个职责全部交给一个 Spark Job,也不要为了普通文件加载引入一个额外分布式计算集群。
参考:Snowflake 数据加载方式 · Snowpipe Streaming 高性能架构
什么时候选 Spark + Snowflake Connector?
如果 Spark 本身就是组织的数据计算平台,并且它还要处理 Snowflake 之外的数据源,或者作业依赖 Spark Structured Streaming、RDD、Spark MLlib、特定 JVM/Python 库和集群级并行控制,那么保留 Spark 是合理的。Snowflake Connector for Spark 让 Spark 读取 Snowflake 表或查询结果,再将 DataFrame 写回 Snowflake;它支持部分查询下推,使一部分计算可以在 Snowflake 内完成,但并不是所有 Spark 操作都能下推,例如 Spark UDF。Spark 仍是外部计算引擎,集群资源、依赖、作业生命周期和 Spark UI 仍由 Spark 平台负责。
因此,Spark + Connector 的优势不在于“比 Snowpark 更适合 Snowflake”,而在于你需要保留一个 Snowflake 之外的 Spark 计算环境。假如数据已经集中在 Snowflake,工作主要是 SQL 关系运算,Connector 反而会引入不必要的数据传输、两套计算资源和更多故障边界。此时应该先比较原生 SQL、Dynamic Tables、Snowpark Python 或 Snowpark Connect。
如果已有 PySpark 代码,但希望实际执行转移到 Snowflake,而不是维持外部 Spark 集群,那么看 Snowpark Connect for Spark。它使用 Spark Connect 客户端协议并映射到 Snowflake 引擎,与传统 Connector 的“外部 Spark 读写 Snowflake”不是同一条路径。它的 API 和语义兼容范围也需要单独评估。
参考:Snowflake Connector for Spark · Snowpark Connect for Apache Spark
一个按工作负载选择的起点
| 工作负载 | 首选评估 | 什么情况下换方案 |
|---|---|---|
| Snowflake 内部的常规 SQL 清洗、Join、聚合 | Snowflake SQL | 需要组织成可复用 Python 代码时考虑 Snowpark |
| 多表、持续刷新、可用 SELECT 描述的 ELT | Dynamic Tables | 需要 MERGE、存储过程或自定义调度时考虑 Streams & Tasks |
| 变更驱动、过程逻辑、定制重试和调度 | Streams & Tasks | 只有声明式刷新需求时,才考虑 Dynamic Tables |
| Snowflake 内的 Python 数据转换与 UDF | Snowpark Python | 需要自定义 OS、GPU 或常驻服务时转向 SPCS |
| Snowflake 内部的模型训练、特征工程和模型生命周期 | Snowflake ML | 它覆盖 Container Runtime、Feature Store、ML Jobs、Model Registry 和 ML Observability;自定义在线服务或特定 GPU 容器部署再评估 SPCS |
| 多个对象存储和数据湖上的批处理或流处理 | Apache Spark / PySpark | 如果主要数据和关系型计算都已在 Snowflake,可评估迁移到 Snowflake 原生计算 |
| 外部 Spark 作业访问 Snowflake 表 | Spark + Snowflake Connector | 不需要外部 Spark 执行能力时,回到 Snowpark/原生 SQL |
| 已有 PySpark 代码希望在 Snowflake 执行 | Snowpark Connect for Spark | 只有在 API、数据源和执行语义兼容时才适合迁移 |
对金融服务数据平台,工作负载选择还要考虑数据权威、访问策略和数据移动成本。Spark 集群访问 Snowflake 数据时,需要明确哪些数据会离开 Snowflake、是否通过临时 Stage 传输、如何审计以及是否涉及跨区域传输。使用 Snowpark 也不代表所有治理要求自动满足:需要检查 Role、Masking Policy、Row Access Policy、包依赖来源和外部网络访问配置。
12. Iceberg 与 Snowpark 是什么关系?一个定义表格式,一个提供计算 API
Apache Iceberg 与 Snowpark 不在同一层。Iceberg 定义数据如何组织成一张开放表;Snowpark 提供用 Python/Java/Scala 表达数据处理逻辑的 API。 两者可以一起使用:Snowpark 可以通过 Snowflake 访问 Iceberg 表,对表数据执行受支持的 SQL/DataFrame 转换;Spark 也可以通过 Iceberg API 访问同一张表。Iceberg 本身不负责运行查询,Snowpark 也不负责定义底层表文件的开放格式。
Iceberg 是开放表格式规范,通常以 Parquet 数据文件保存记录,以 manifest 和 metadata 文件描述文件、分区、Schema 和 Snapshot,再由 Catalog 维护表名到当前元数据位置的映射,并通过原子更新维护表状态。它提供 ACID 表操作、Schema Evolution、Hidden Partitioning 和 Snapshot 等能力。它解决的是“多个计算引擎如何围绕同一批文件理解并维护一张表”,而不是“由哪个引擎执行 Join”。
Snowflake 中的 Iceberg 有两种管理方式
Snowflake 支持 Snowflake-managed Iceberg Tables,也支持通过外部 Iceberg Catalog 使用 externally managed Iceberg tables。两者的区别首先是 Catalog 的控制权,而不只是文件放在哪个云存储。
Snowflake-managed Iceberg 由 Snowflake 维护 Iceberg Catalog 和表生命周期。数据文件可以存放在 Snowflake Storage,也可以存放在客户自己管理的对象存储,并通过 External Volume 连接。换言之,“Snowflake-managed”不必然等于“文件必须存储在 Snowflake 的内部存储”。这种模式更适合想保留 Iceberg 开放格式,同时又希望由 Snowflake 管理目录、元数据维护和主要表生命周期的场景。
Externally managed Iceberg 则由外部 Catalog 管理表元数据,例如 AWS Glue、Databricks Unity Catalog 或 Snowflake Open Catalog。Snowflake 通过 Catalog Integration 连接外部 Catalog;对远程 Iceberg REST Catalog,可以使用 Catalog-Linked Database 自动发现和同步其中的 Namespace 与表。外部 Catalog 仍是表元数据的权威来源,Snowflake 不会自动接管这类表的所有生命周期维护。具体写入和功能支持取决于外部 Catalog、存储配置与 Iceberg 表类型。
| 维度 | Snowflake-managed Iceberg | Externally managed Iceberg |
|---|---|---|
| Catalog 权威 | Snowflake | 外部 Iceberg Catalog |
| 数据文件位置 | Snowflake Storage 或客户自己的对象存储 | 外部云存储 |
| 元数据维护 | Snowflake 管理表生命周期和维护操作 | 主要由外部 Catalog 和外部存储体系负责 |
| Snowflake 访问方式 | 原生 Iceberg Table 对象 | Catalog Integration;常见情况下通过 Catalog-Linked Database 访问 |
| 适用场景 | 希望 Snowflake 管理表,但保留 Iceberg 开放格式 | 已经有 Iceberg Lakehouse,希望 Snowflake 与现有 Spark/Trino/Databricks 等引擎共享表 |
需要区分两个独立问题:谁管理 Catalog,以及谁管理数据文件存储。 对 Snowflake-managed Iceberg,Catalog 由 Snowflake 管理,但文件可以放在客户云存储;对外部 Catalog 表,元数据由外部系统管理,文件也在外部存储。不要把“managed/unmanaged”简单等同于“数据在 Snowflake 内/外”。
官方资料:Apache Iceberg tables in Snowflake · Iceberg storage options · Catalog-linked Database
Iceberg 与 Snowpark、Spark 如何组合?
如果 Iceberg 表已经在 Snowflake 中以受支持的 Iceberg Table 对象暴露出来,Snowflake SQL 和 Snowpark 可以对它执行支持范围内的查询和转换。Snowpark 的 DataFrame 仍然由 Snowflake 引擎处理,底层数据文件和 Snapshot 则遵循 Iceberg 规范。
Snowpark Connect for Spark 也支持读取和写入 Snowflake-managed 与 externally managed Iceberg tables。开发者可以通过标准 Spark DataFrame 和 Spark SQL API 访问它们,客户端仍使用 Spark 风格的代码,但执行引擎是 Snowflake。需要安装相应 Iceberg 扩展并核对 Snowpark Connect 版本与表类型的支持矩阵;不能因此假设全部 Iceberg Spark API、全部 Spark API 和所有 Iceberg Catalog 都能无差别使用。
外部 Spark 集群也可以直接读取 Iceberg 表。这通常是开放 Lakehouse 的重要价值:数据文件不必为了不同计算引擎而重复复制。但如果外部引擎要访问受 Snowflake Row Access Policy 或 Masking Policy 保护的 Iceberg 数据,还要设计治理执行路径。Snowflake 当前提供 Snowflake Connector for Spark 和 Iceberg REST Catalog Scan Plan API 两种方式,把支持的行级和列级策略应用到外部查询;这不是 Iceberg 格式本身自动提供的安全能力。
| 组合 | 谁执行计算 | Iceberg 的作用 |
|---|---|---|
| Snowflake SQL + Iceberg | Snowflake SQL Engine | Snowflake 查询开放格式表 |
| Snowpark Python + Iceberg | Snowflake SQL Engine | 用 Python DataFrame API 构建对 Iceberg 表的转换 |
| Snowpark Connect + Iceberg | Snowflake SQL Engine | 复用受支持的 Spark DataFrame API 访问 Iceberg |
| 外部 Spark + Iceberg | 外部 Spark 集群 | Spark 直接读写开放表格式 |
| 外部 Spark + Snowflake Connector + Iceberg 治理 | Spark + Snowflake 访问路径 | 在跨引擎查询时应用 Snowflake 支持的数据保护策略 |
什么时候值得选 Iceberg,而不是普通 Snowflake Table?
如果数据只由 Snowflake 使用,而且没有把底层文件交给其他计算引擎的需求,普通 Snowflake Table 通常更直接,Snowflake 特有的表管理、查询和数据治理能力也更完整。不要为了“开放格式”而默认把每张表都改成 Iceberg。
如果数据要同时被 Snowflake、Spark、Trino、Databricks 或其他 Iceberg 兼容引擎访问,或者组织要求数据文件保留在自己的对象存储、Catalog 由现有 Lakehouse 平台掌控,那么 Iceberg 的价值就很明确。它减少了不同引擎之间对专有表存储格式的耦合,但并不会消除 Catalog、权限、数据文件维护、压缩合并、Snapshot 过期、云存储成本和跨区域数据传输等责任。
Snowflake 对 Iceberg 的支持也不是所有 Snowflake 原生表能力的等价替代。不同表类型的功能支持范围存在差异;例如外部管理表的克隆、复制、Streams 等能力受到限制,客户自管存储的保护和恢复责任也与 Snowflake Storage 不同。设计前应核对 Iceberg 功能与限制 及 Snowpark Connect Iceberg 支持矩阵。
13. 动手学习:先在本地跑 PySpark,再用 Snowpark 操作同一类数据
学习 Spark 不必先搭建 Kubernetes 或云端集群。可以在本地安装 PySpark,用少量数据观察 DataFrame API、惰性执行和执行计划。下面的示例不依赖 Java 代码;Spark 的运行时仍然需要 JVM 环境,但开发者只需通过 Python API 交互。
python -m venv .venv
source .venv/bin/activate
pip install pyspark
pyspark
在交互式环境中:
from pyspark.sql import SparkSession, functions as F

spark = SparkSession.builder.appName("spark-intro").getOrCreate()

rows = [
    ("2026-11-01", "A100", "USD", 120.0, "VALID"),
    ("2026-11-01", "A100", "USD", 80.0, "VALID"),
    ("2026-11-01", "B200", "EUR", 50.0, "INVALID"),
    ("2026-11-02", "A100", "USD", 40.0, "VALID"),
]

df = spark.createDataFrame(
    rows,
    ["trade_date", "account_id", "currency", "amount", "status"]
)

summary = (
    df.filter(F.col("status") == "VALID")
      .groupBy("trade_date", "account_id", "currency")
      .agg(F.sum("amount").alias("total_amount"))
)

summary.explain("formatted")
summary.show()
先不要急着调参数。观察 explain() 输出,理解过滤和聚合如何出现在计划中;然后尝试加入 Join、排序和写入操作,再到 Spark UI 查看 Job、Stage、Task。最后把数据规模放大,比较分区数量、Shuffle 和倾斜对执行时间的影响。
Snowpark Python 的入门方式不同:需要 Snowflake 账号、角色、Warehouse 和连接配置。可以在本地 VS Code 或 Jupyter 安装 Snowpark Python 客户端,通过 Session 连接 Snowflake;代码在本地构建 DataFrame 表达式,查询执行由 Snowflake 负责。官方 Quickstart 包含数据工程管道和 Python/Streamlit 示例,适合沿着实际平台流程学习。
建议按这个顺序学习,避免一开始被集群配置和各种组件淹没:
- PySpark DataFrame:读取 Parquet/CSV,练习 select、filter、join、groupBy、窗口函数和写入。
- 惰性执行与执行计划:区分 Transformation 和 Action,学会使用 explain。
- 分区与 Shuffle:观察 repartition/coalesce、Join、聚合的任务变化和数据倾斜。
- Spark SQL 与性能诊断:理解 Catalyst、AQE、广播 Join、列裁剪、谓词下推和小文件问题。
- Structured Streaming:理解流式 DataFrame、Checkpoint、Watermark、状态与输出模式。
- 生产部署:再学习 Kubernetes/YARN、依赖分发、作业调度、日志和资源隔离。
- Snowpark Python:在 Snowflake 内用相同的数据转换思路实现 SQL 型管道,观察 Query History 和 Warehouse 消耗。
- Snowpark Connect:只有在确实存在 PySpark 迁移需求时,再研究 Spark Connect 协议和 API 兼容矩阵。
参考学习入口:Spark Quick Start · PySpark 官方文档 · Structured Streaming · Snowpark Python Developer Guide · Snowpark Python 数据工程 Quickstart
14. 最后厘清几个不同层次
Apache Spark 是分布式计算引擎;Snowpark 是在 Snowflake 上表达数据处理逻辑的开发 API;Snowpark Connect 则让受支持的 Spark Connect DataFrame 工作负载通过 Snowflake 引擎执行。它们回答的是“计算由谁执行、使用什么编程接口”。
Snowflake SQL、Dynamic Tables、Streams & Tasks、Snowpipe、UDF/Stored Procedure、Snowflake ML 和 Snowpark Container Services 分别处理查询、数据管道、调度、数据摄取、自定义函数、机器学习生命周期和容器化计算。选型时应先用最贴近任务的原生能力,不要把所有数据流程都改造成 Spark Job 或 Snowpark 程序。
Iceberg 是另一层:它定义数据文件、表元数据和 Snapshot 如何组成开放表。Snowflake、Snowpark、Spark 或 Trino 都可以成为访问它的计算方式,前提是目标引擎支持相应表类型和操作。要不要用 Iceberg,主要看是否需要跨引擎互操作、开放存储和外部 Catalog,而不是看团队使用了 Snowpark 还是 Spark。
因此,一个完整的数据平台可以同时使用 Snowflake 原生表、Iceberg 表、Snowpark 和外部 Spark。真正需要做的架构决定,是分别确定表格式与 Catalog、计算引擎、数据摄取方式以及管道编排机制,再检查它们之间的权限、兼容性和运营边界。